马上注册,结交更多好友,享用更多功能,让你轻松玩转社区。
您需要 登录 才可以下载或查看,没有账号?立即注册
×
这次整理电商评论数据,本来只是想把空值清掉再做分词。真正跑完检查才发现,直接删掉所有含空值的行会把5000条记录压到999条,问题根本不在评论正文,而在一些这次用不到的辅助字段。下面把这次从检查到导出的过程记下来。 一、这次为什么先做清洗
这次整理的是一份电商评论表,原表有5000条记录、10个字段,后面要拿正文做分词和情感分析。导入后先用shape和isna().sum()检查,发现正文为空4条、评分为空3条,同时有不少地点、时间等辅助字段为空。若把所有含空值的行一次性删掉,5000条只会剩999条;这显然不是正文分析需要的结果。 二、我先把“全表删空值”停下来
用df.dropna()做对比时,评论正文其实并不是主要的缺失来源。地点字段缺失3260条、成员字段缺失1860条、时间字段缺失1706条,但这些字段并不参与这次文本分析。真正需要处理的只有正文、评分和情感标签三列。因此后面改成了按列处理:正文为空删行,评分缺失才考虑补齐,标签缺失才标记unknown。 三、正文空值和评分空值不能混着处理
正文先fillna(''),再用正则把换行和连续空格合并。处理后仍为空的4条记录直接删除;没有正文就没有后续分词输入。评分用pd.to_numeric转换后,原表里有3个缺失值;但这3条刚好都落在被删除的空正文记录里,所以过滤正文后评分待补齐数变成0。代码仍保留中位数补齐分支,便于后续换数据时直接复用。 四、最后一处问题是重复评论
空正文过滤后剩4996条。我再按content去重,保留第一次出现的文本,删除483条重复记录,最终得到4513条可用于分析的评论。去重放在文本清洗之后,是为了避免同一句评论只是换行或多了空格却没有被识别出来。导出的CSV使用UTF-8 with BOM,直接用Excel打开不会乱码。 清洗后的结果
这次最直观的收获是:缺失值不能一把梭。全表dropna把5000条压到999条,损失的是仍有完整正文的可用样本;按字段处理后,最终保留4513条。真正应该记录的不是“用了fillna”,而是每种处理对应的字段、数量和理由。后面做词频、主题或分类模型时,也可以通过rating_was_missing等标记列回查补齐过的数据。 五、关键代码与复现方法
- """评论表缺失值处理:删除、统计量补齐、显式标记三种方法。"""
- from pathlib import Path
- import pandas as pd
- INPUT = Path('京东小米评论集.xlsx')
- OUTPUT = Path('comments_clean.csv')
- def report(stage, frame):
- print(f'\n[{stage}] rows={len(frame)}')
- print('空正文:', int(frame['content'].eq('').sum()))
- print('评分缺失:', int(frame['rating'].isna().sum()))
- print('标签缺失:', int(frame['sentiment'].isna().sum()))
- # 1. 读取后先标准化字段;rating 使用实际表中的第4列,避免中文列名编码差异。
- raw = pd.read_excel(INPUT)
- print('原表行数:', len(raw))
- print('整表 dropna 后行数(仅作对比):', len(raw.dropna()))
- data = pd.DataFrame({
- 'content': raw['content'].fillna('').astype(str).str.replace(r'\s+', ' ', regex=True).str.strip(),
- 'rating': pd.to_numeric(raw.iloc[:, 3], errors='coerce'),
- 'sentiment': raw['content_type'].astype('string'),
- })
- report('原始检查', data)
- # 方法一:正文为空没有文本分析价值,删除;不要对整张表无差别 dropna。
- data = data.loc[data['content'].ne('')].copy()
- print('删除空正文后:', len(data))
- # 方法二:评分是数值字段,用中位数补齐,并留下补齐标记便于回溯。
- data['rating_was_missing'] = data['rating'].isna()
- rating_median = data['rating'].median()
- data['rating'] = data['rating'].fillna(rating_median)
- print('评分中位数:', rating_median)
- print('补齐评分条数:', int(data['rating_was_missing'].sum()))
- # 方法三:标签为空时显式标记 unknown,而不是猜测正面或负面。
- data['sentiment_was_missing'] = data['sentiment'].isna()
- data['sentiment'] = data['sentiment'].fillna('unknown').str.strip()
- data.loc[data['sentiment'].eq(''), 'sentiment'] = 'unknown'
- # 最后按正文去重;keep='first' 保留首次出现的记录。
- before_dedup = len(data)
- data = data.drop_duplicates(subset=['content'], keep='first').reset_index(drop=True)
- print('删除重复正文条数:', before_dedup - len(data))
- report('清洗完成', data)
- # 输出时保留两列标记,之后可单独分析“补齐数据”是否影响结论。
- data.to_csv(OUTPUT, index=False, encoding='utf-8-sig')
- print(f'已保存:{OUTPUT.resolve()}')
图里能直接看到:空正文只有4条、评分缺失3条,重复正文却有486条。这个差异也说明这次清洗的重点不该放在一键删空值,而要放在正文筛选和文本去重上。 file:///C:/Users/wxy/AppData/Local/Temp/ksohtml34564/wps1.jpg
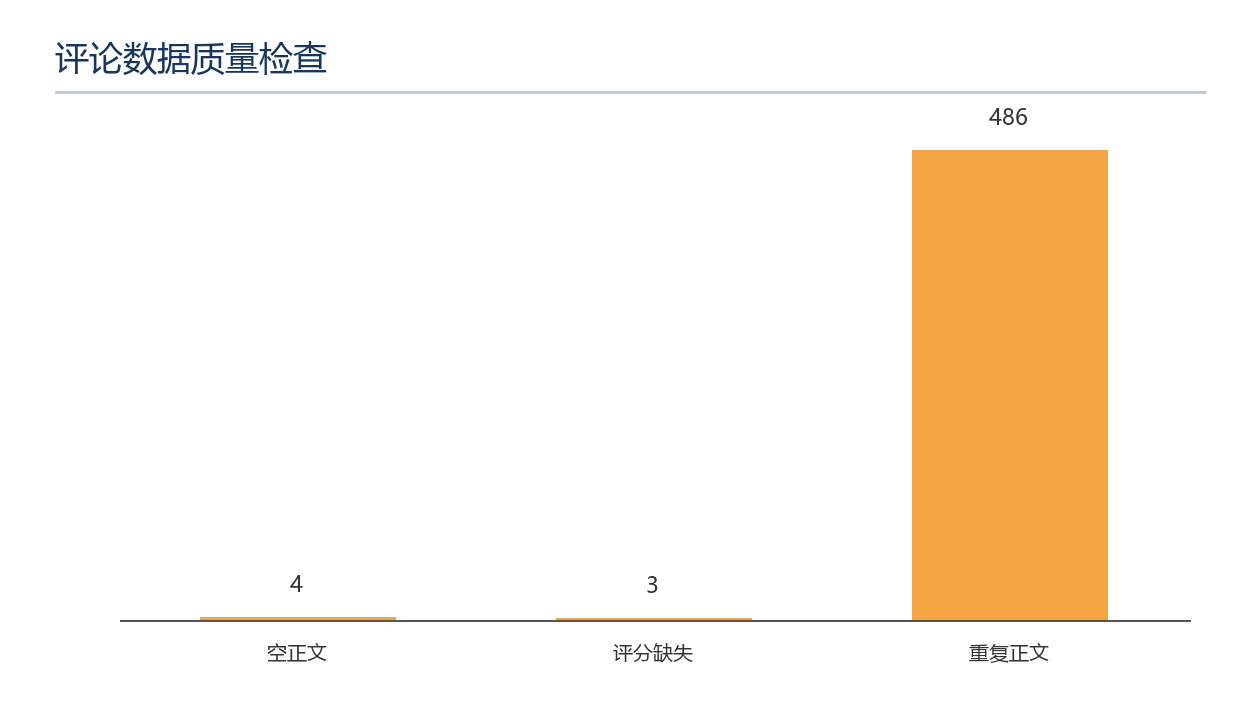
图:原始评论表中的空值与重复值检查
七、设计结论
这次清洗最终保留4513条评论。和整表dropna只剩999条相比,按字段处理保住了大部分有正文的样本,也把真正无效的空文本和重复文本清掉了。 八、结束语
给刚开始用pandas的同学一个提醒:不要一打开文件就写dropna()。先跑一遍df.info()和isna().sum(),看清楚到底是哪一列在缺、这一列还要不要用,再决定删、填还是保留未知值。 九、关键词
pandas;缺失值;数据清洗;评论数据;数据质量
|
 学研领航向全体高校师生打造的一站式综合交流与资源服务平台,集知识学习、经验分享、资源下载、互动问答、职场成长、兼职实践于一体,覆盖校园生活、专业学习、求职就业、兴趣发展等全场景需求。