马上注册,结交更多好友,享用更多功能,让你轻松玩转社区。
您需要 登录 才可以下载或查看,没有账号?立即注册
×
Python数据分析速成笔记(Pandas数据清洗+Matplotlib可视化+实战案例)
/ O a6 i# p9 q+ F7 ~, a+ G8 z$ V; F/ }3 z* e6 }
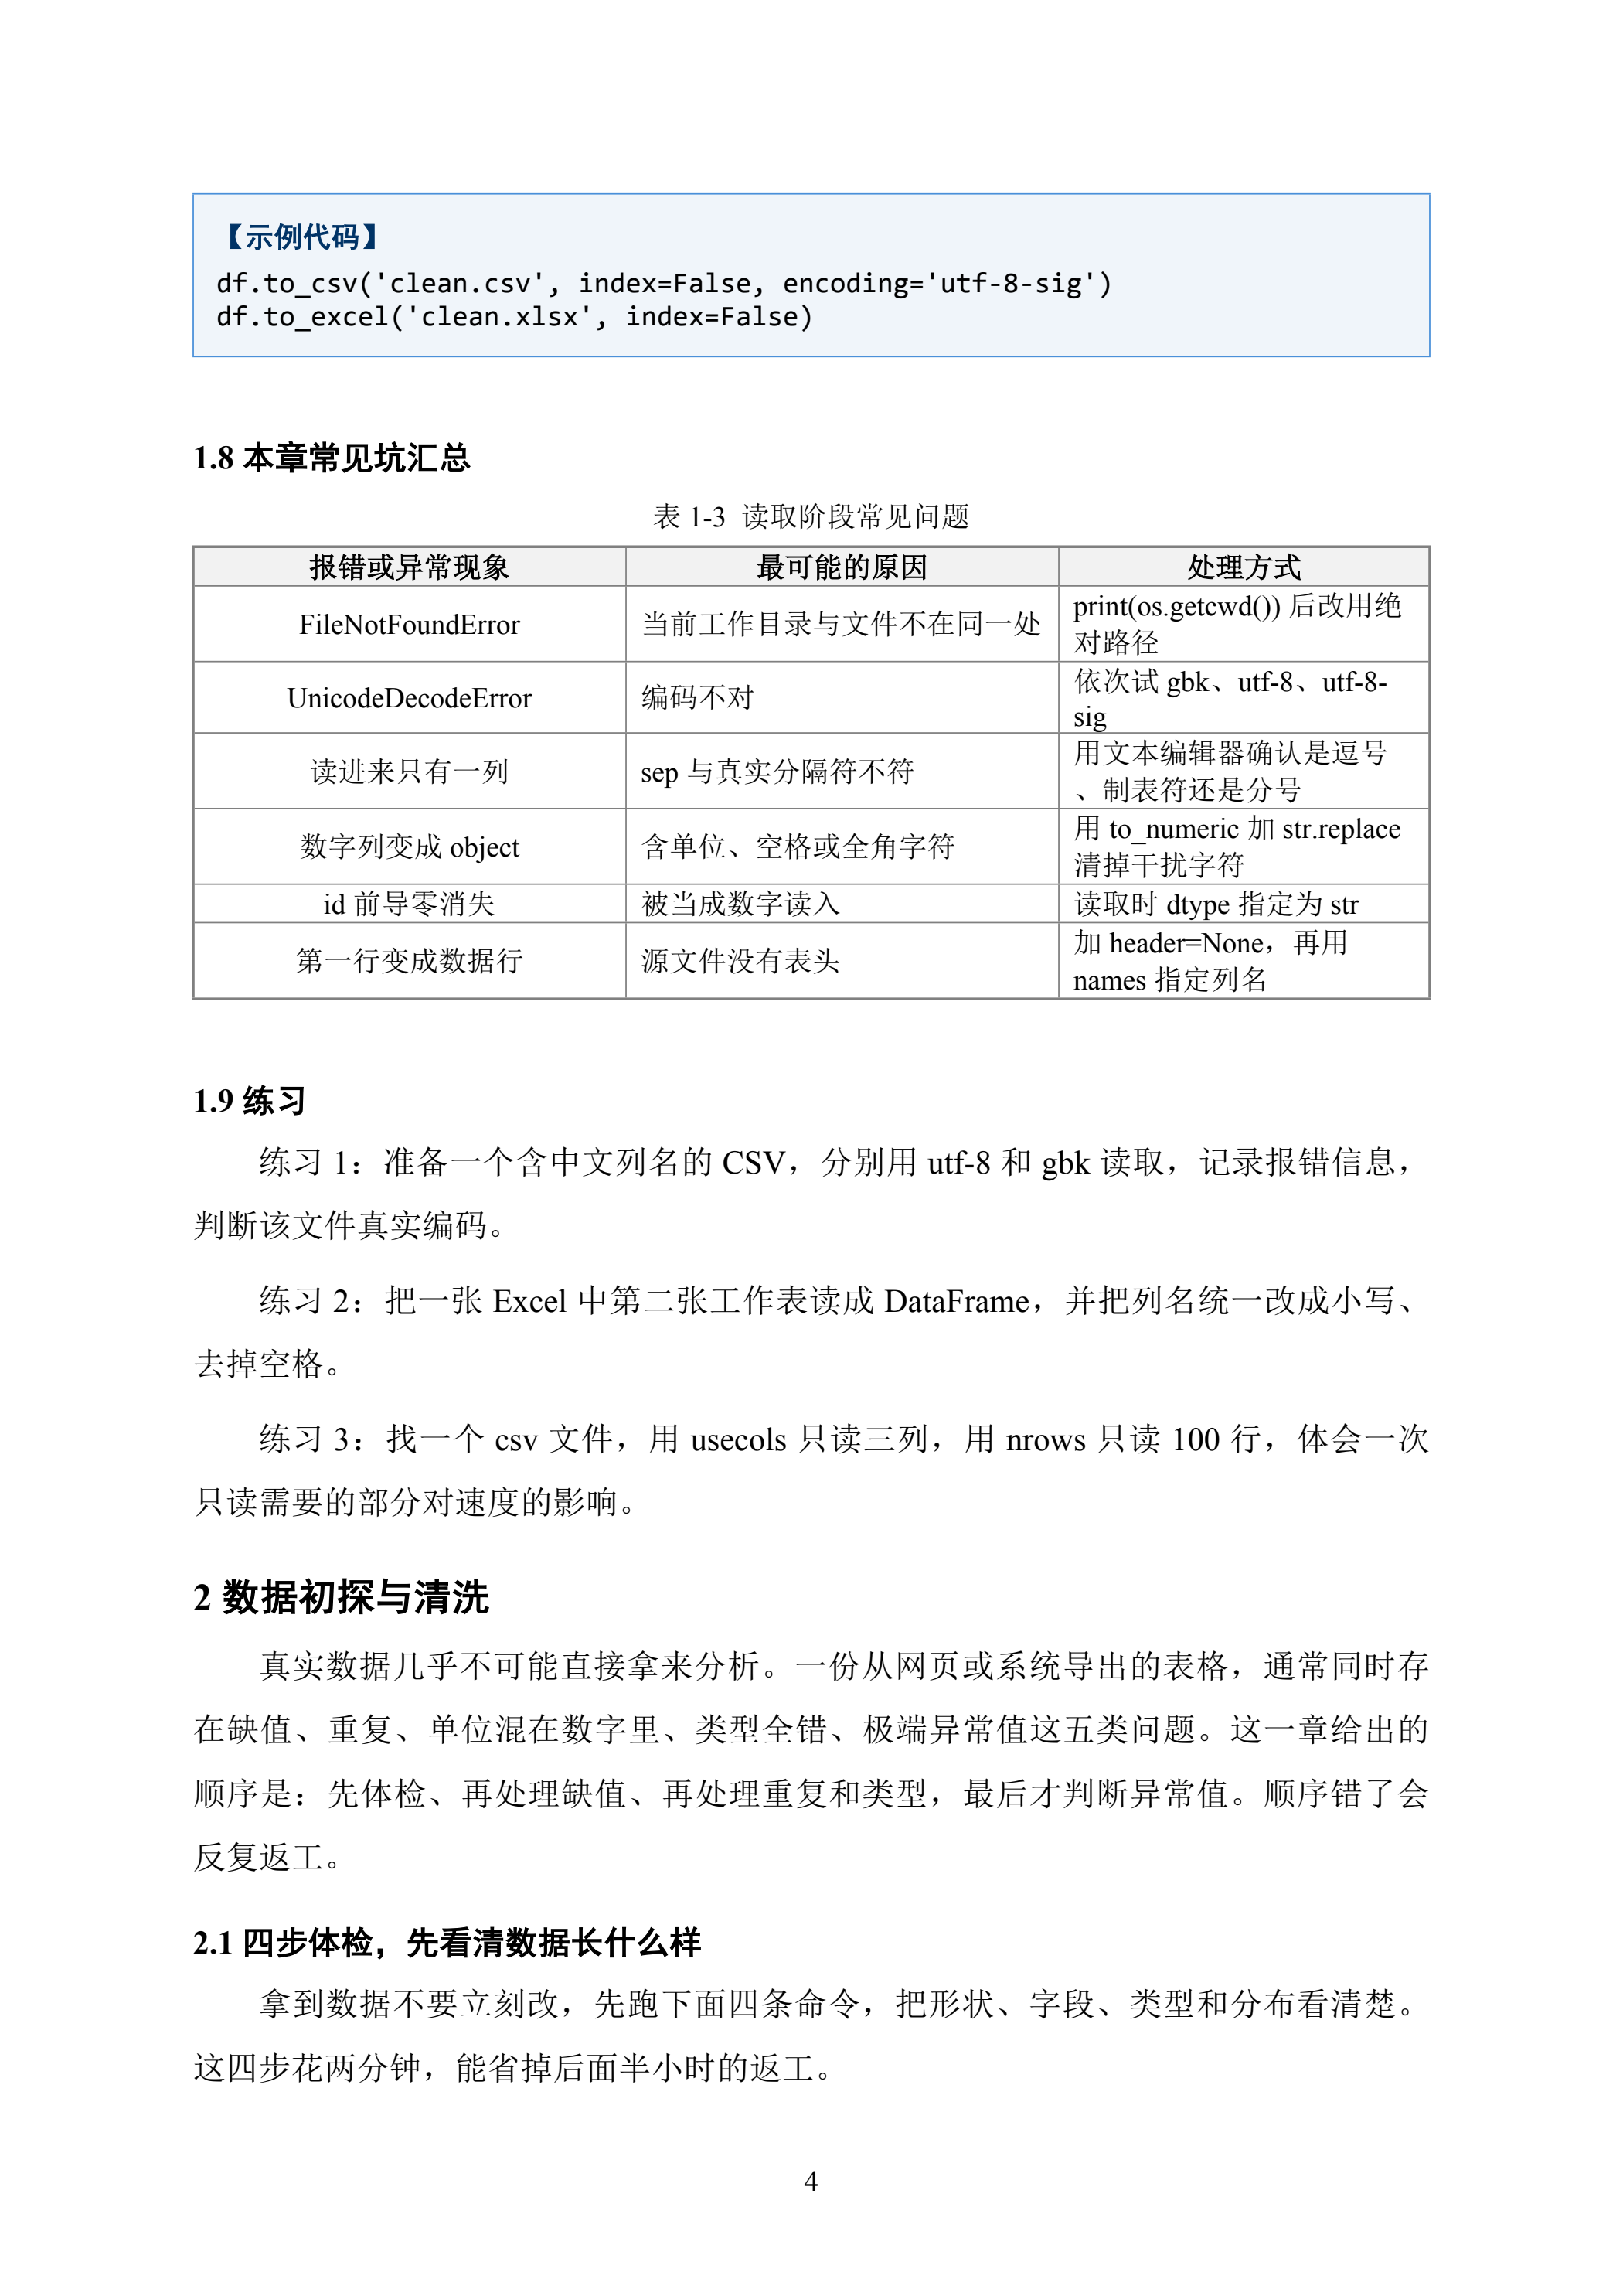
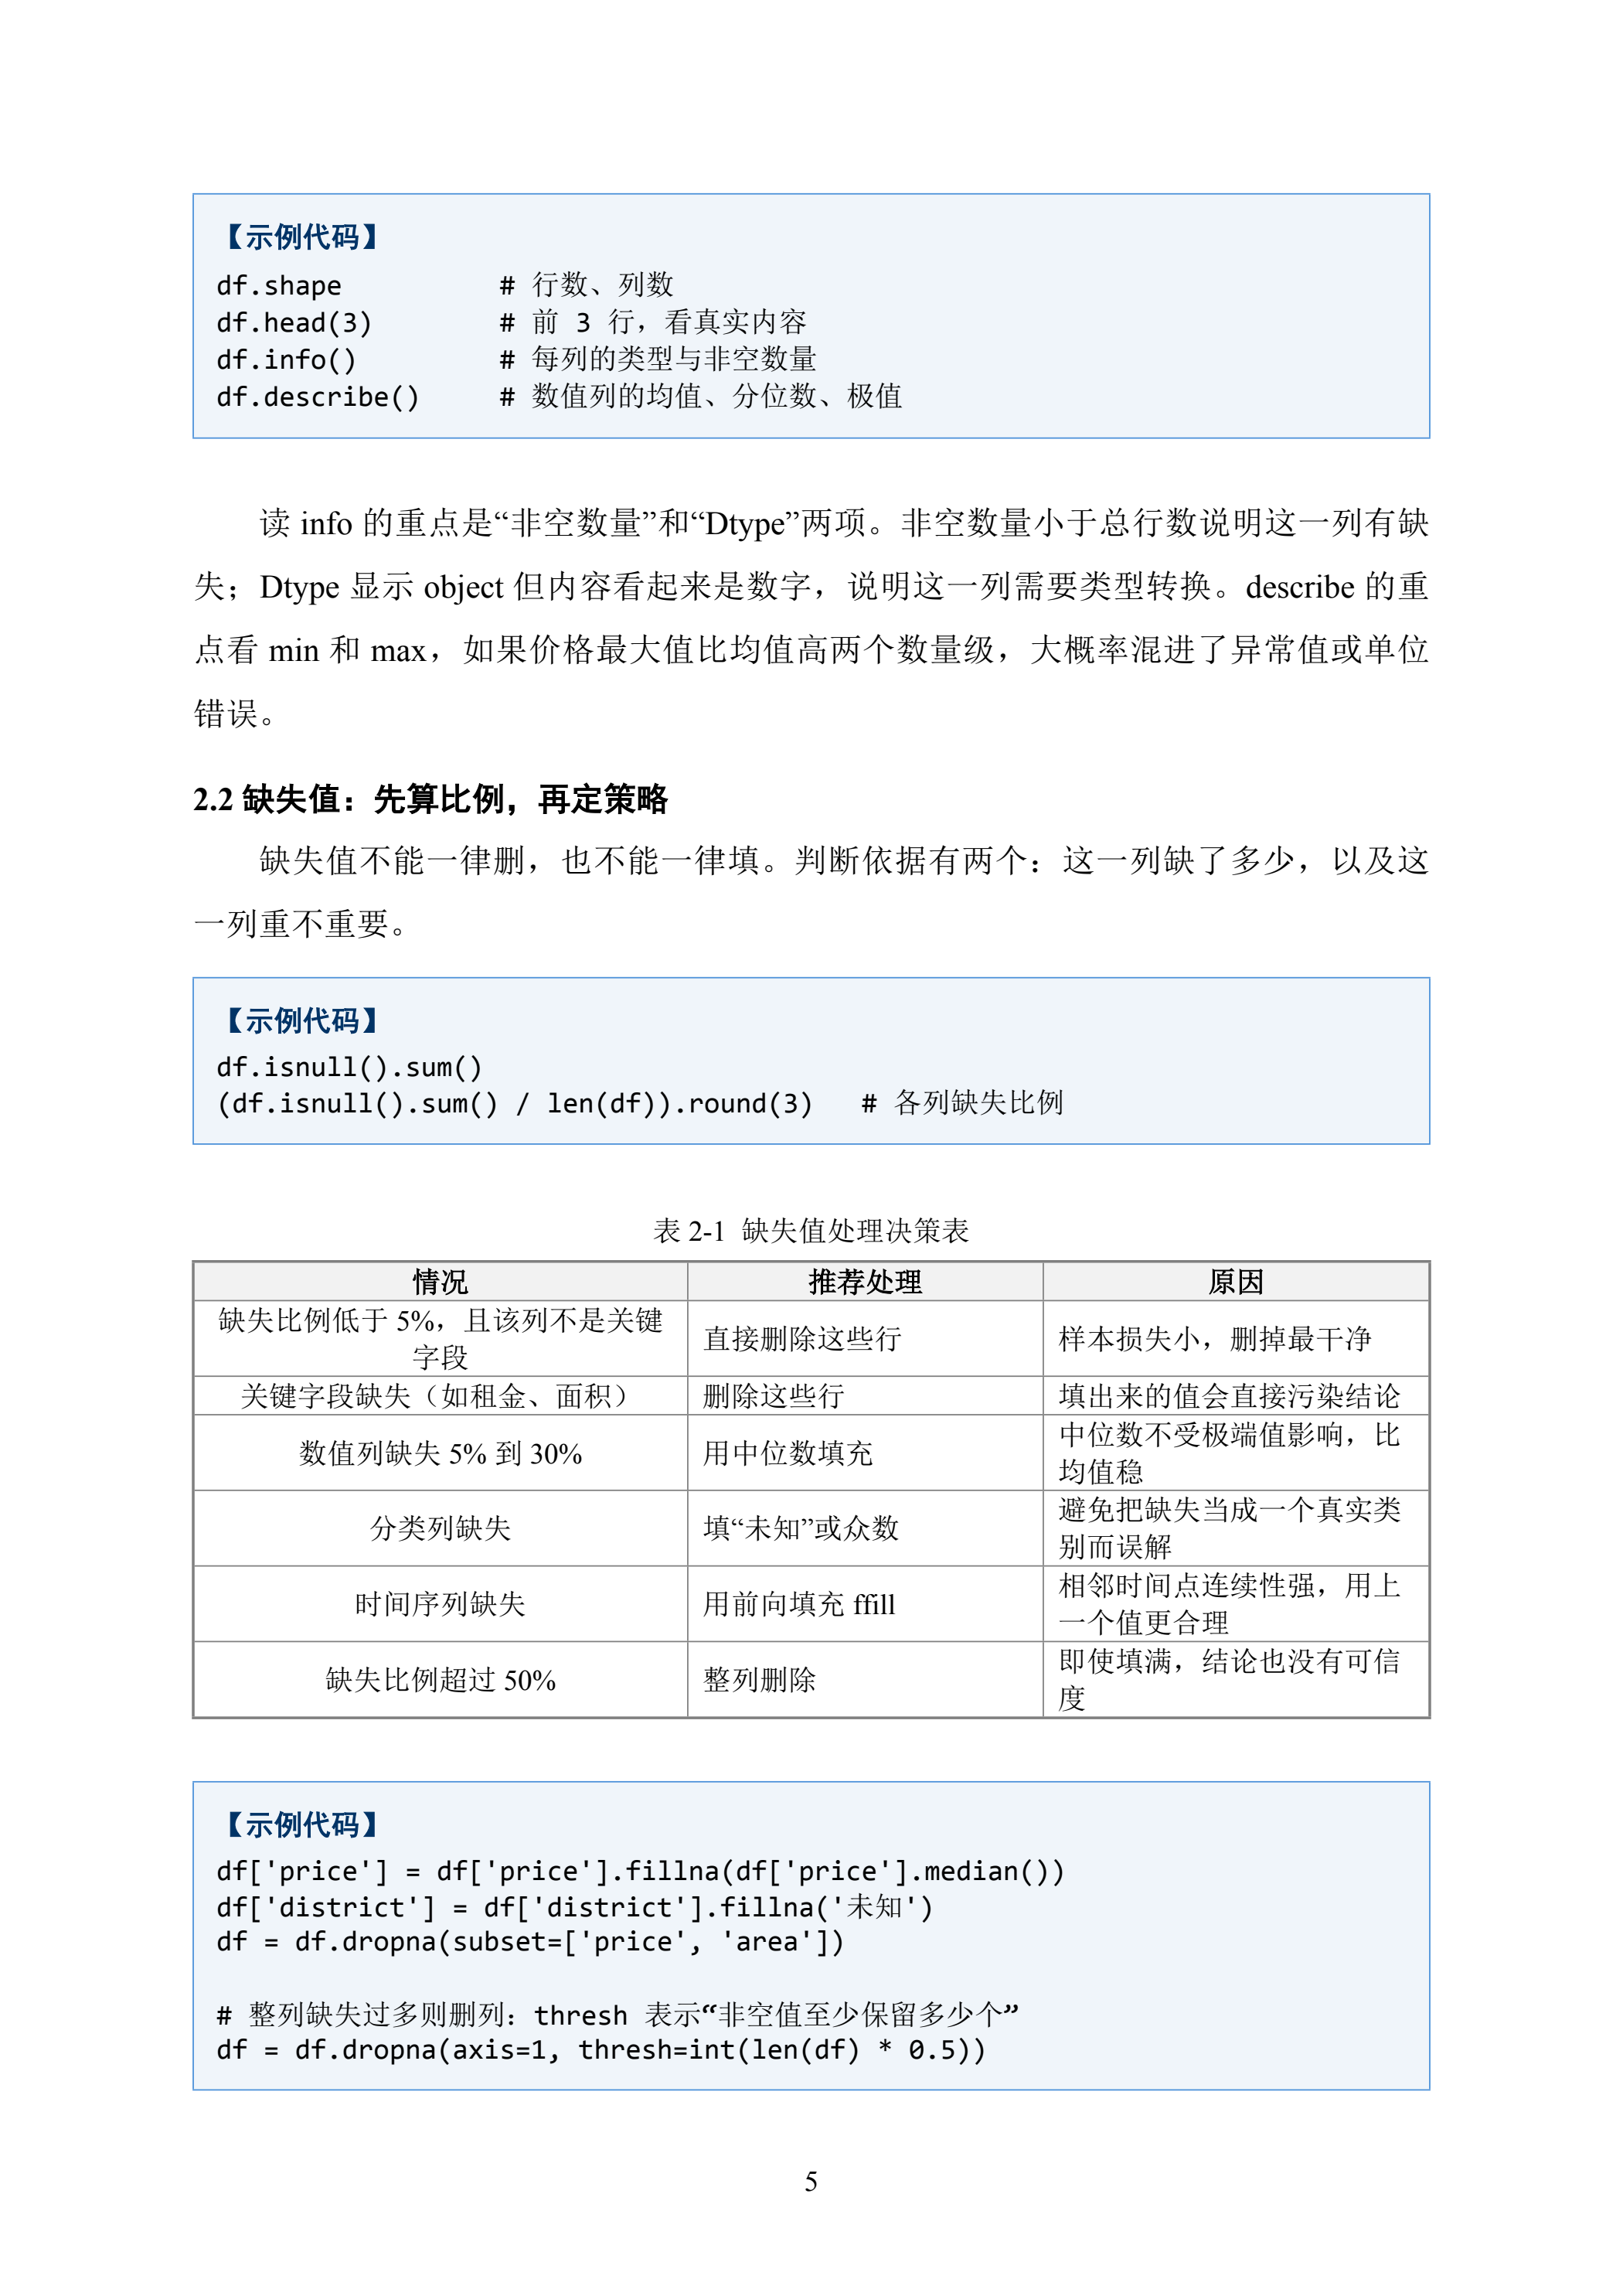
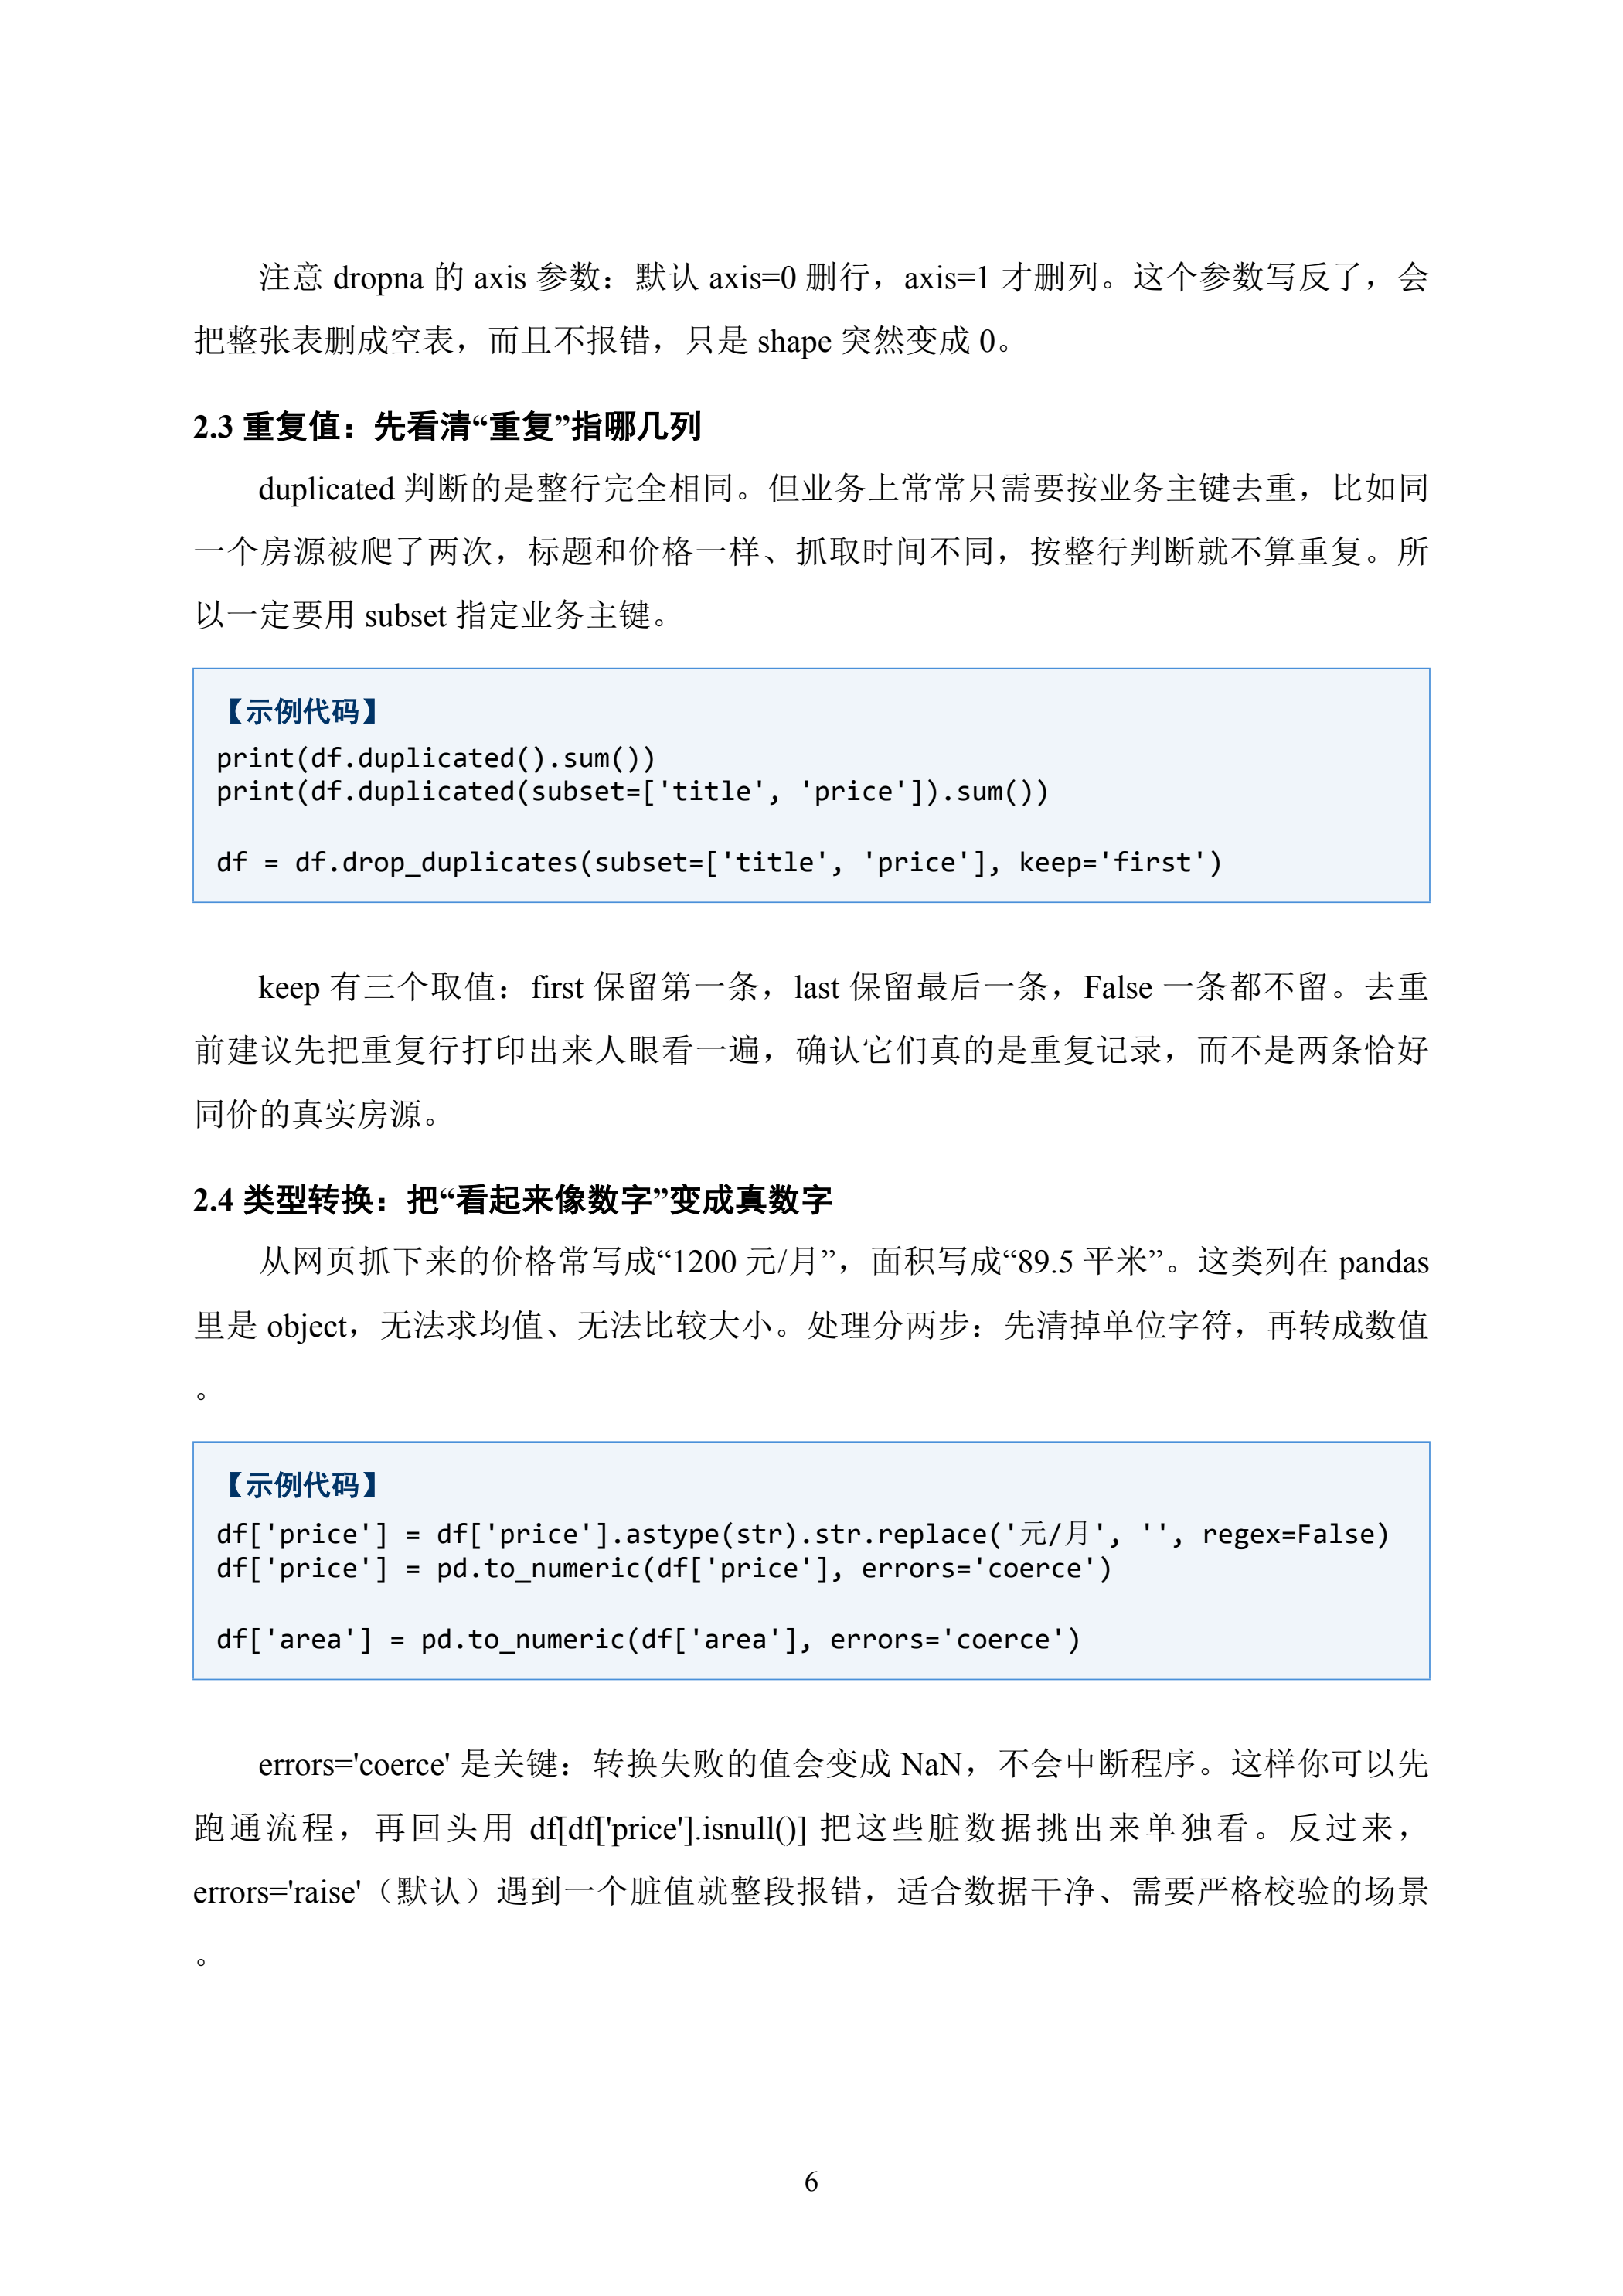
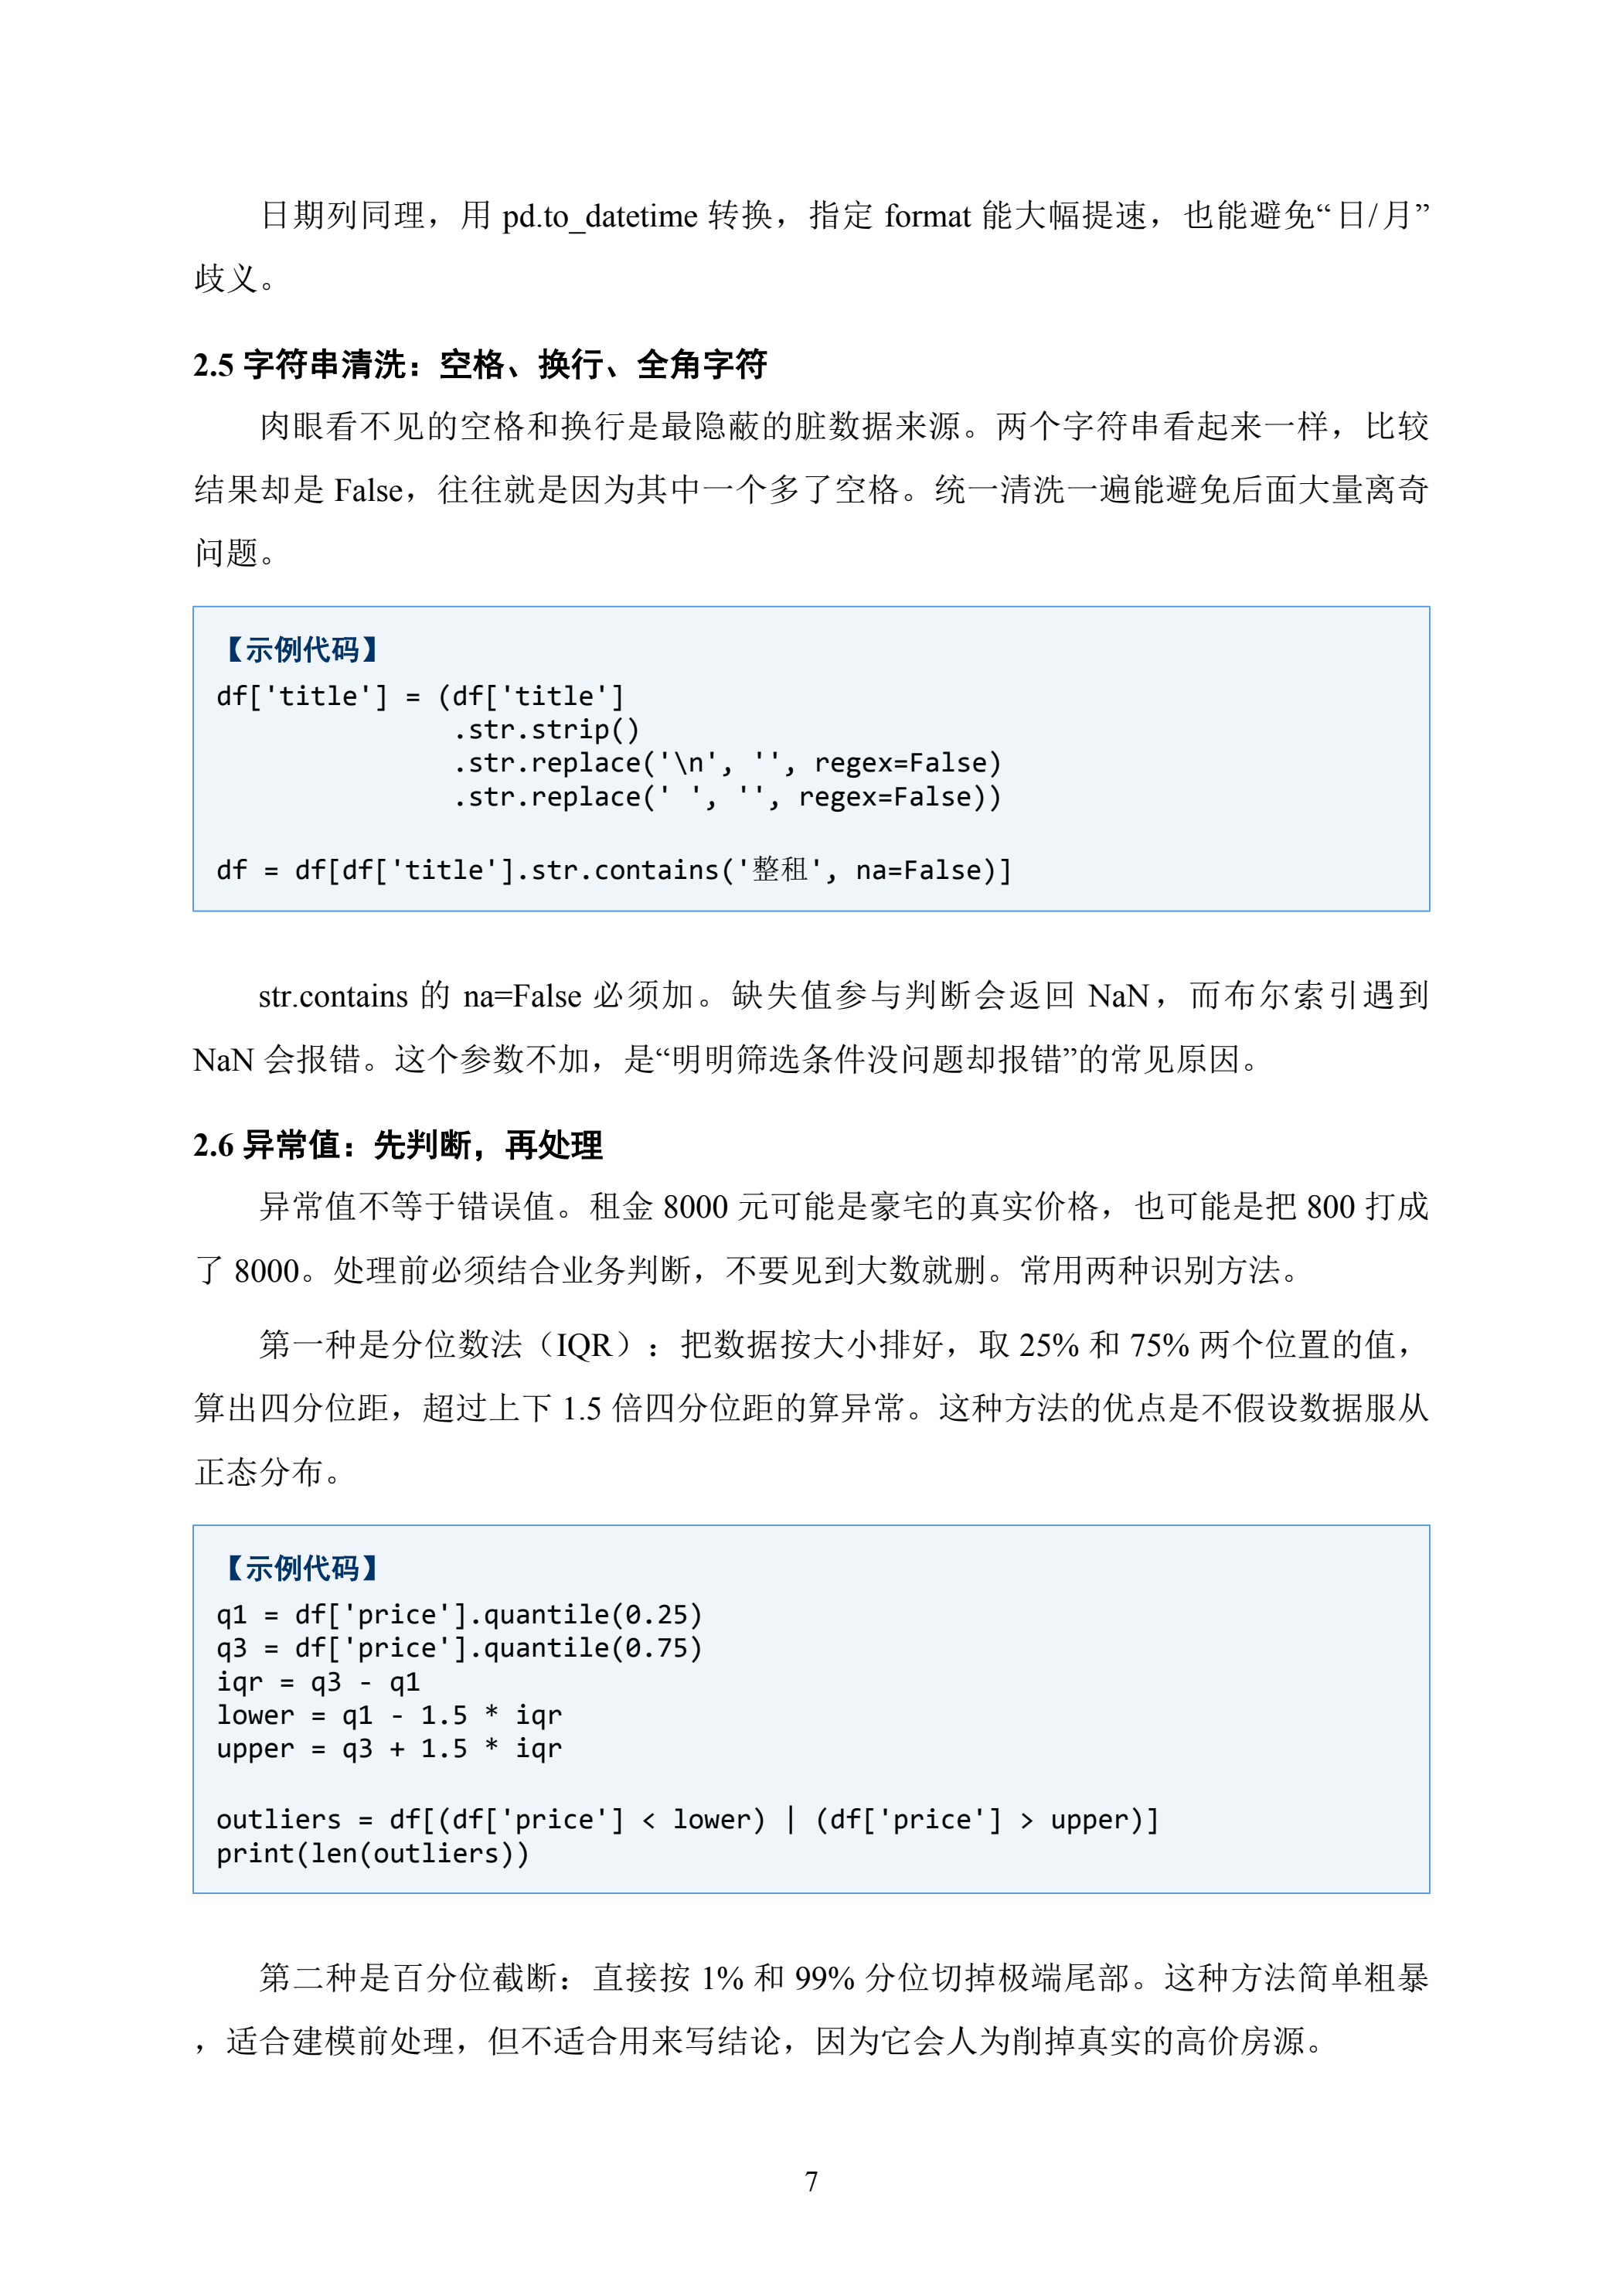
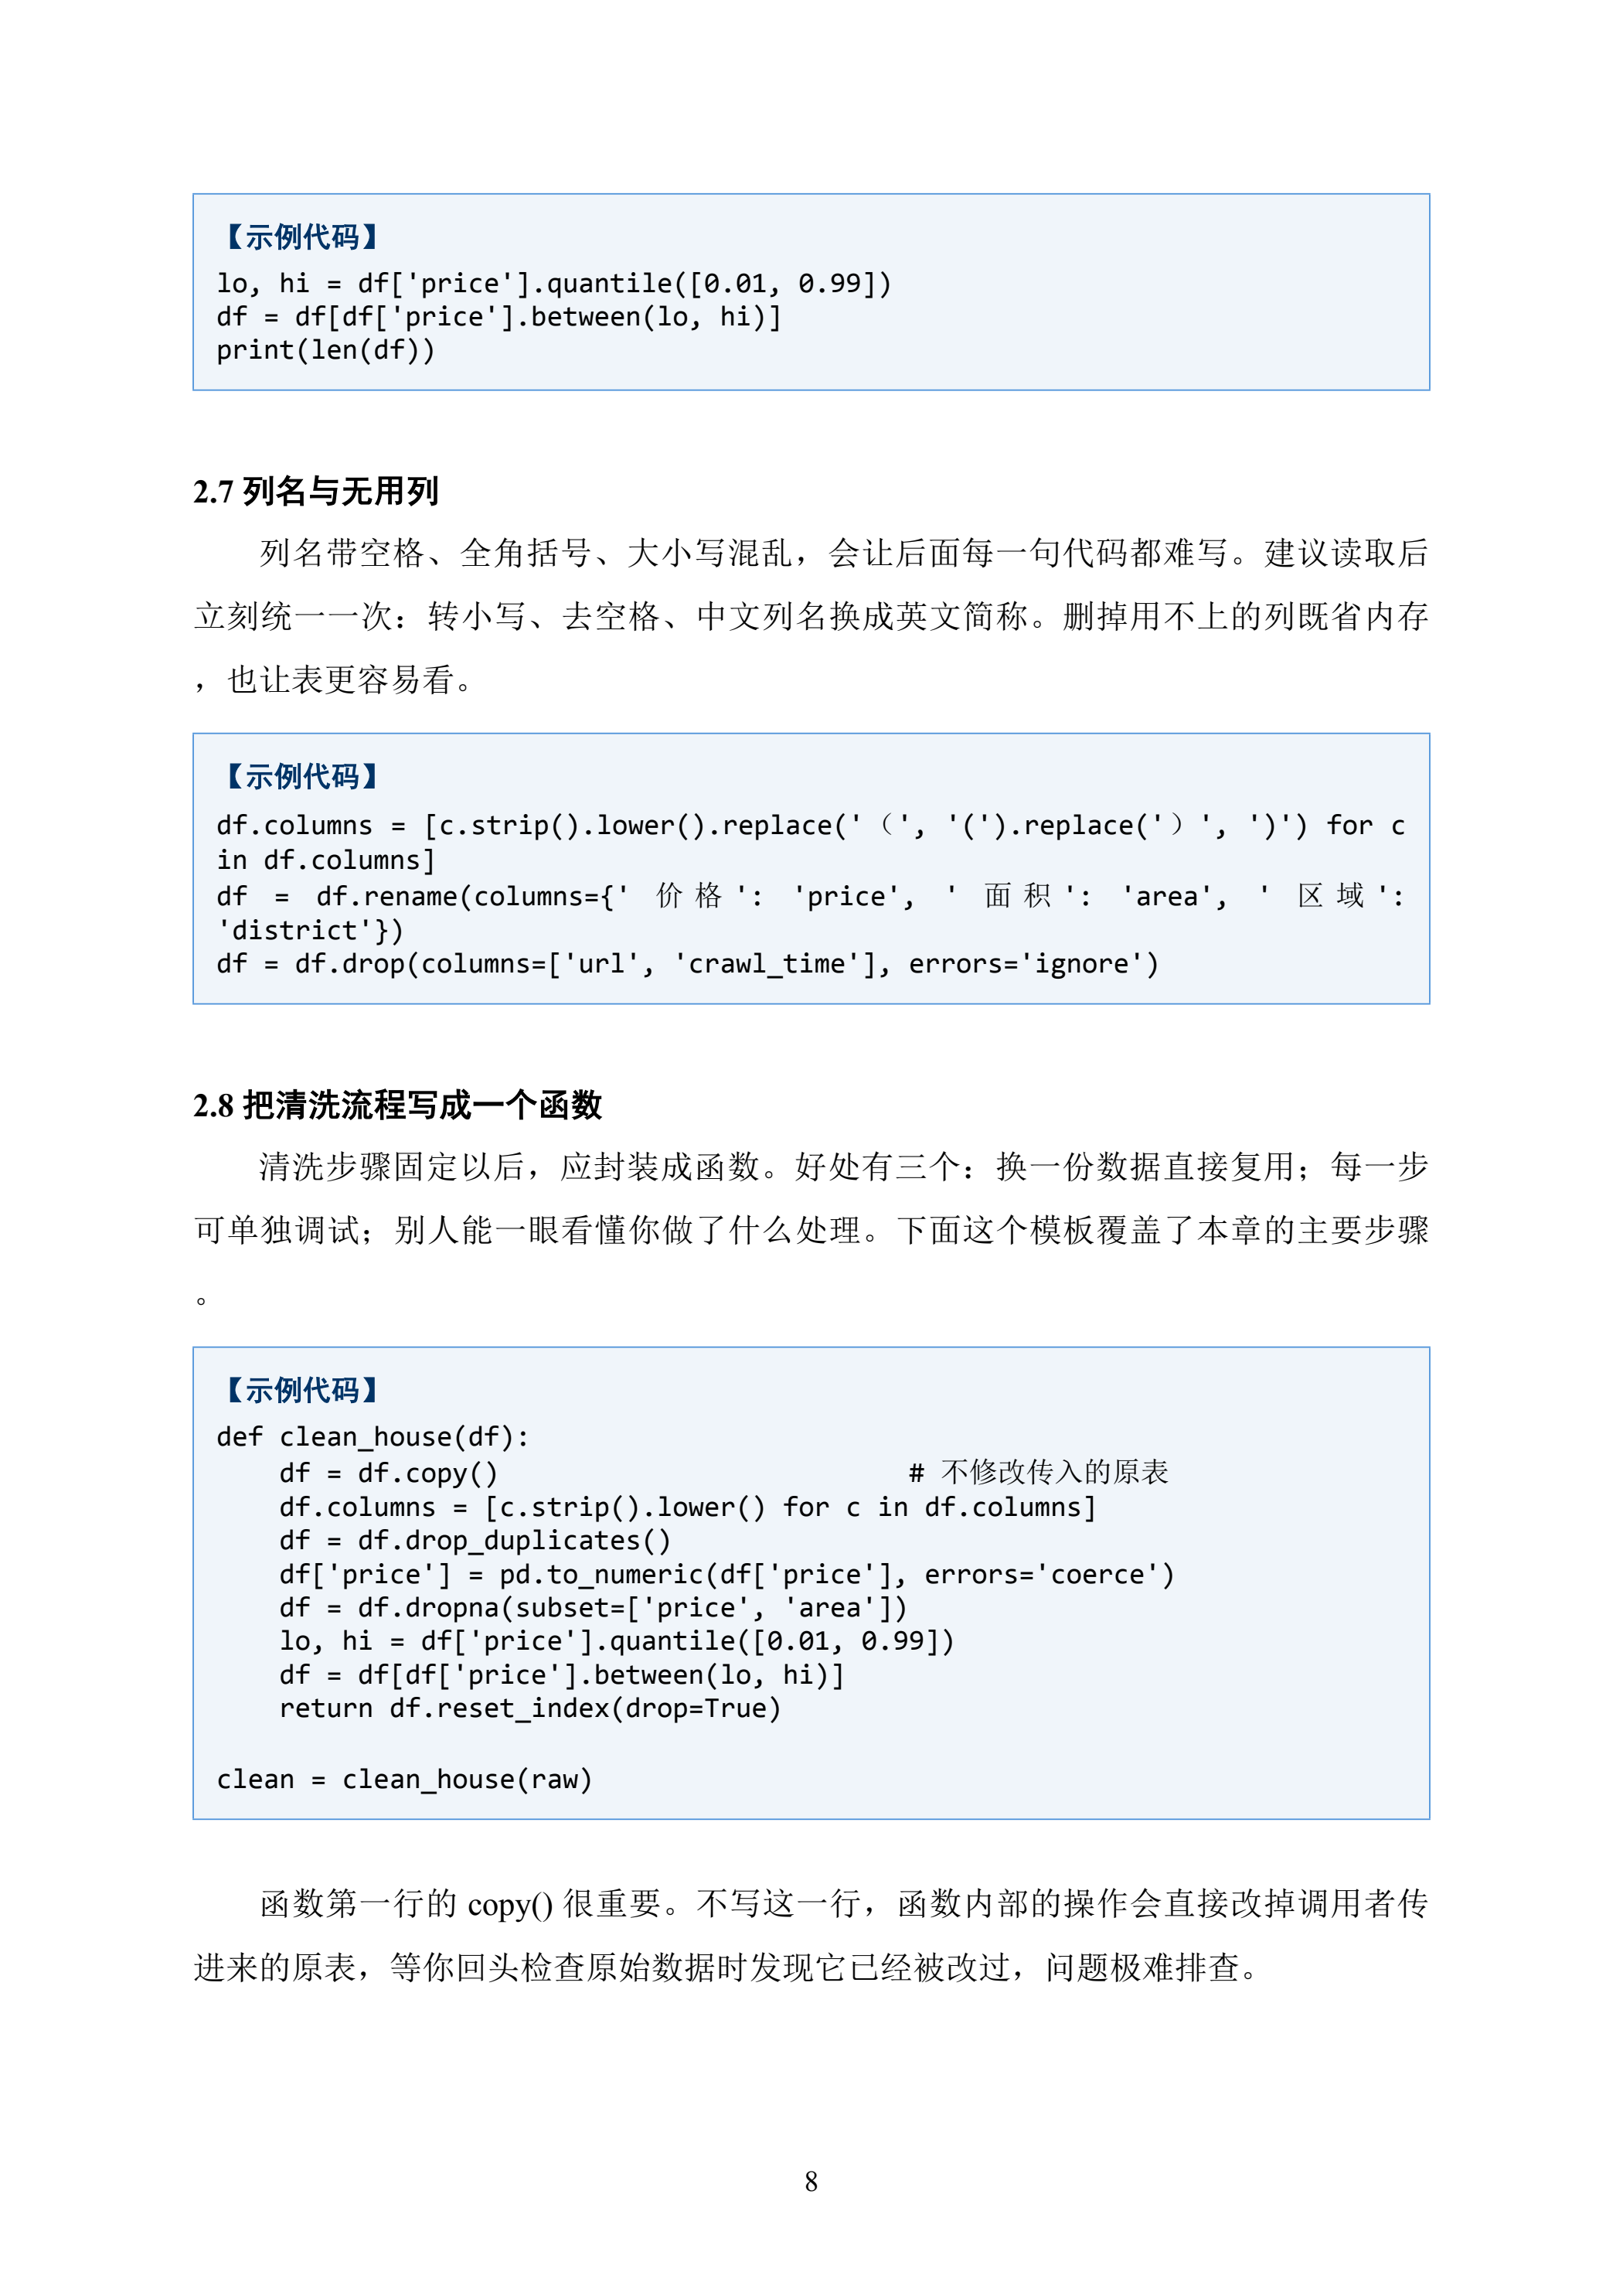
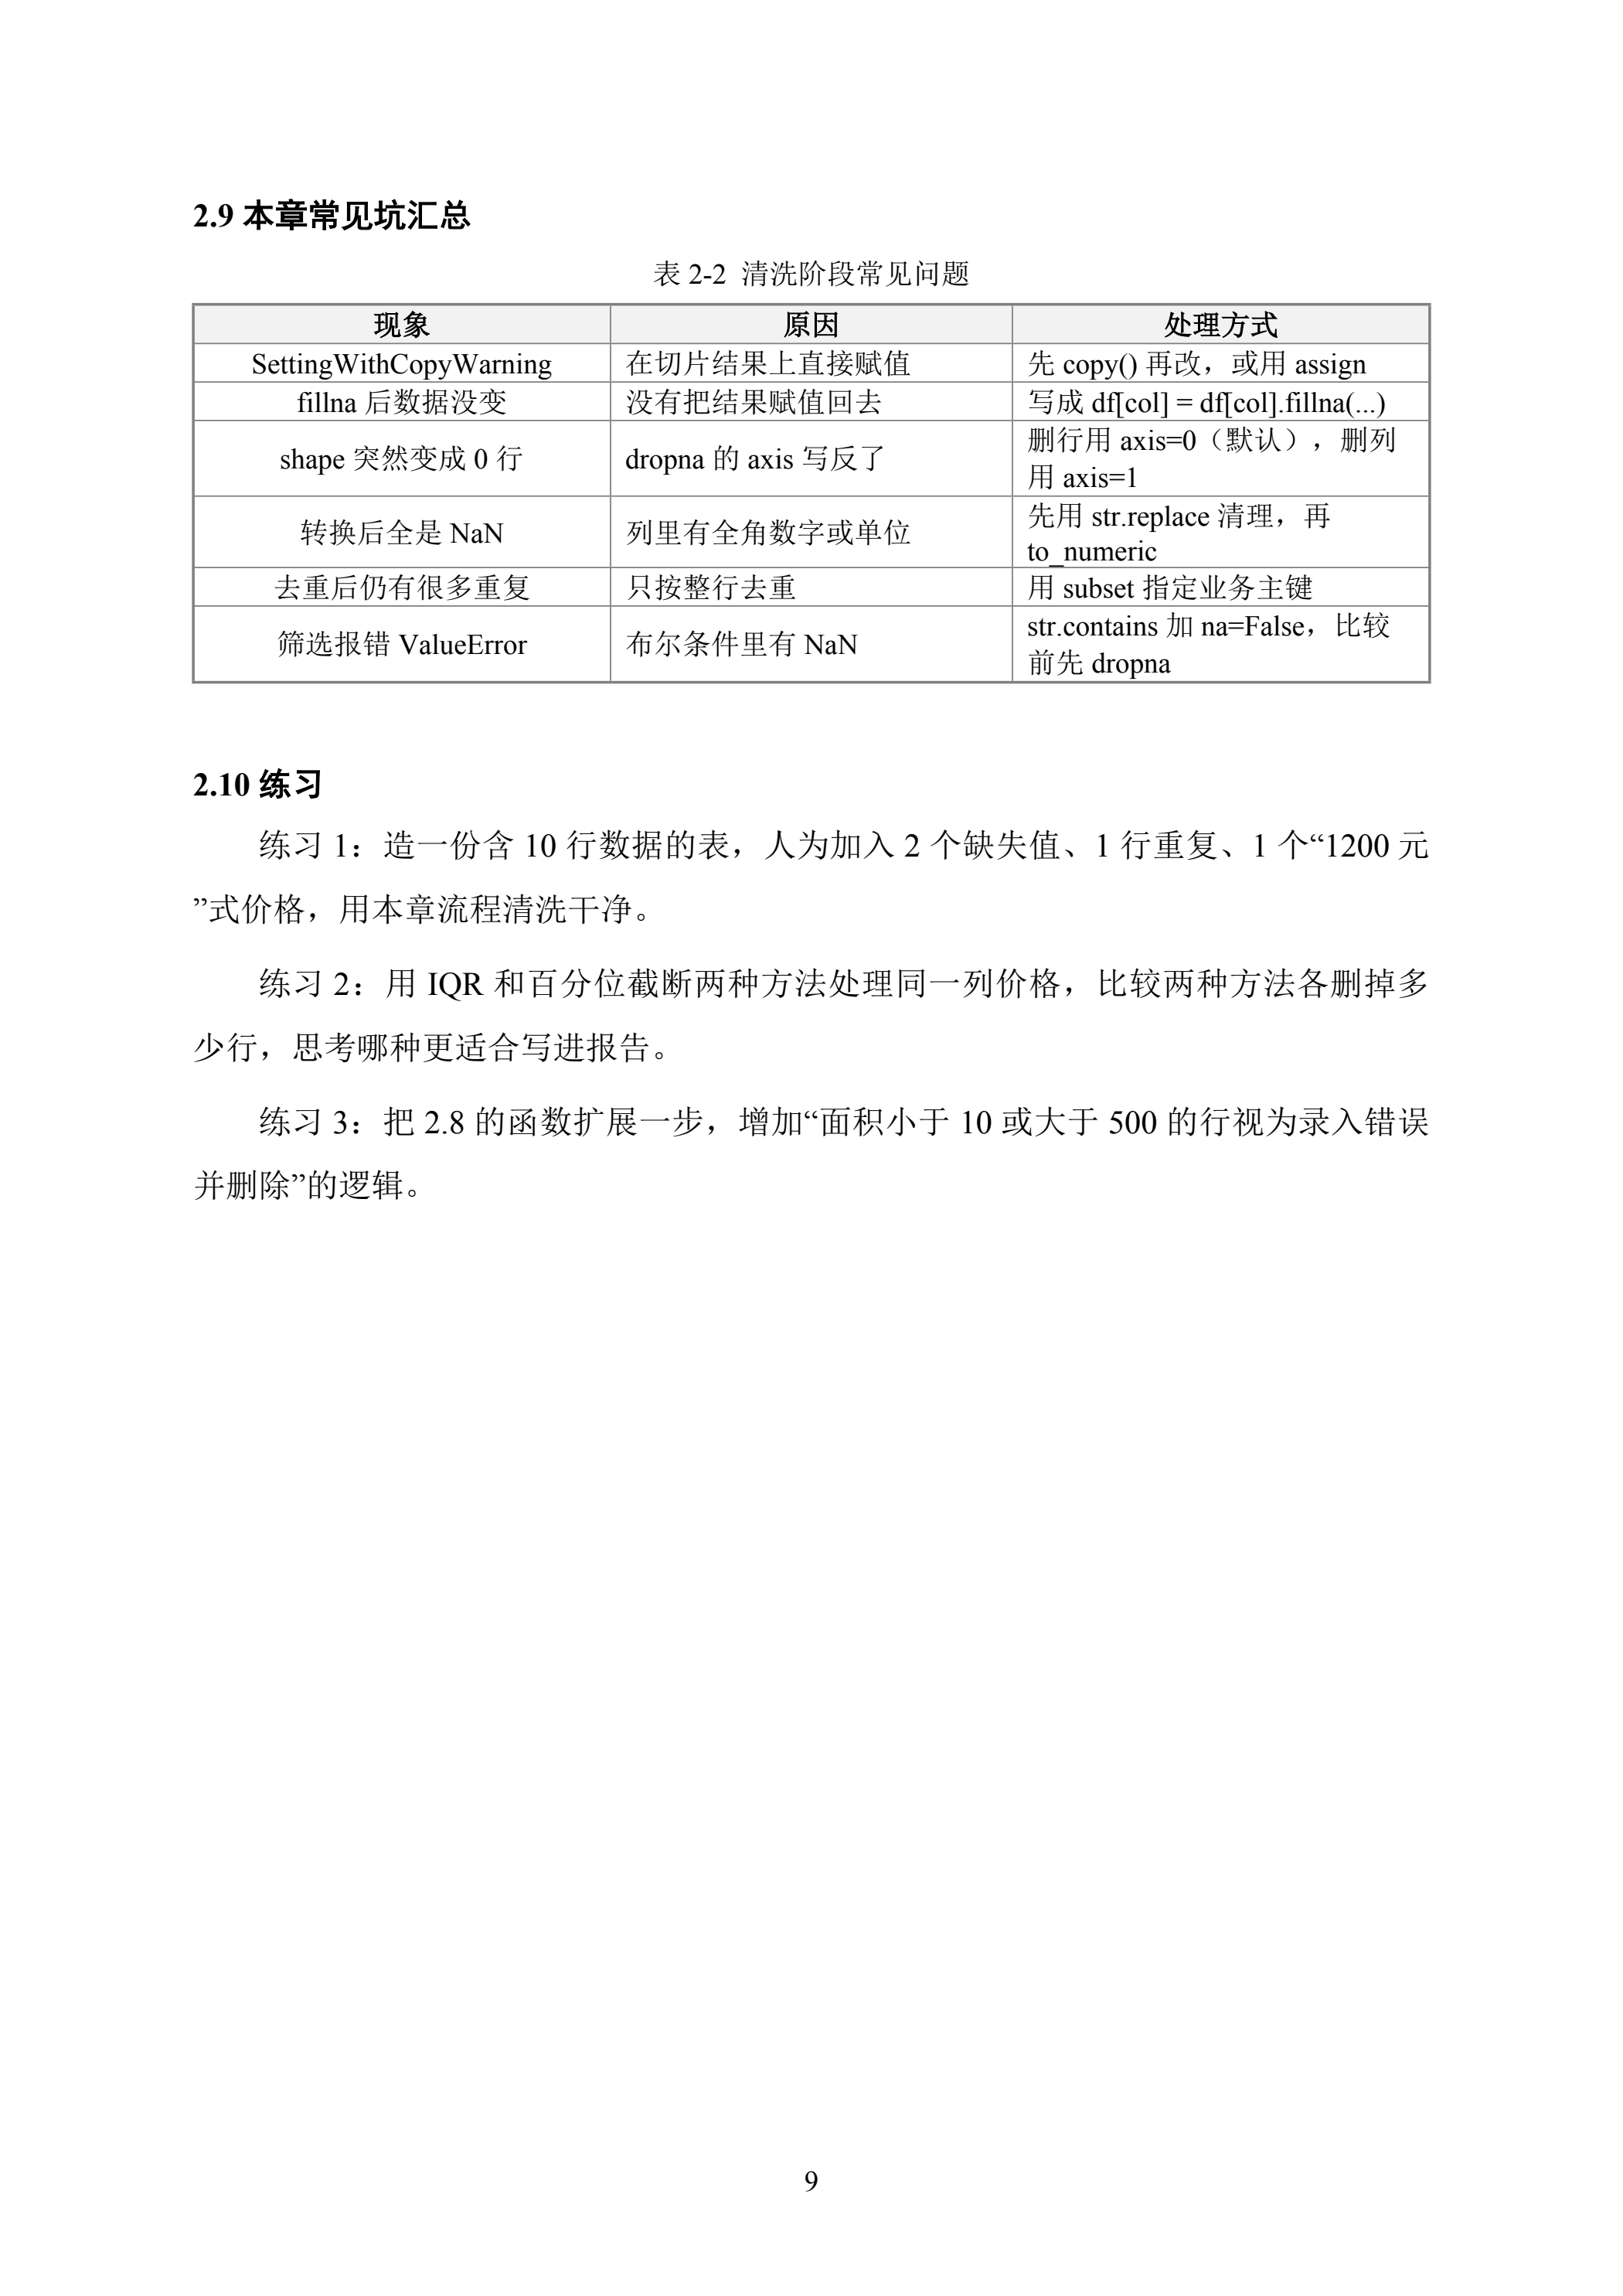
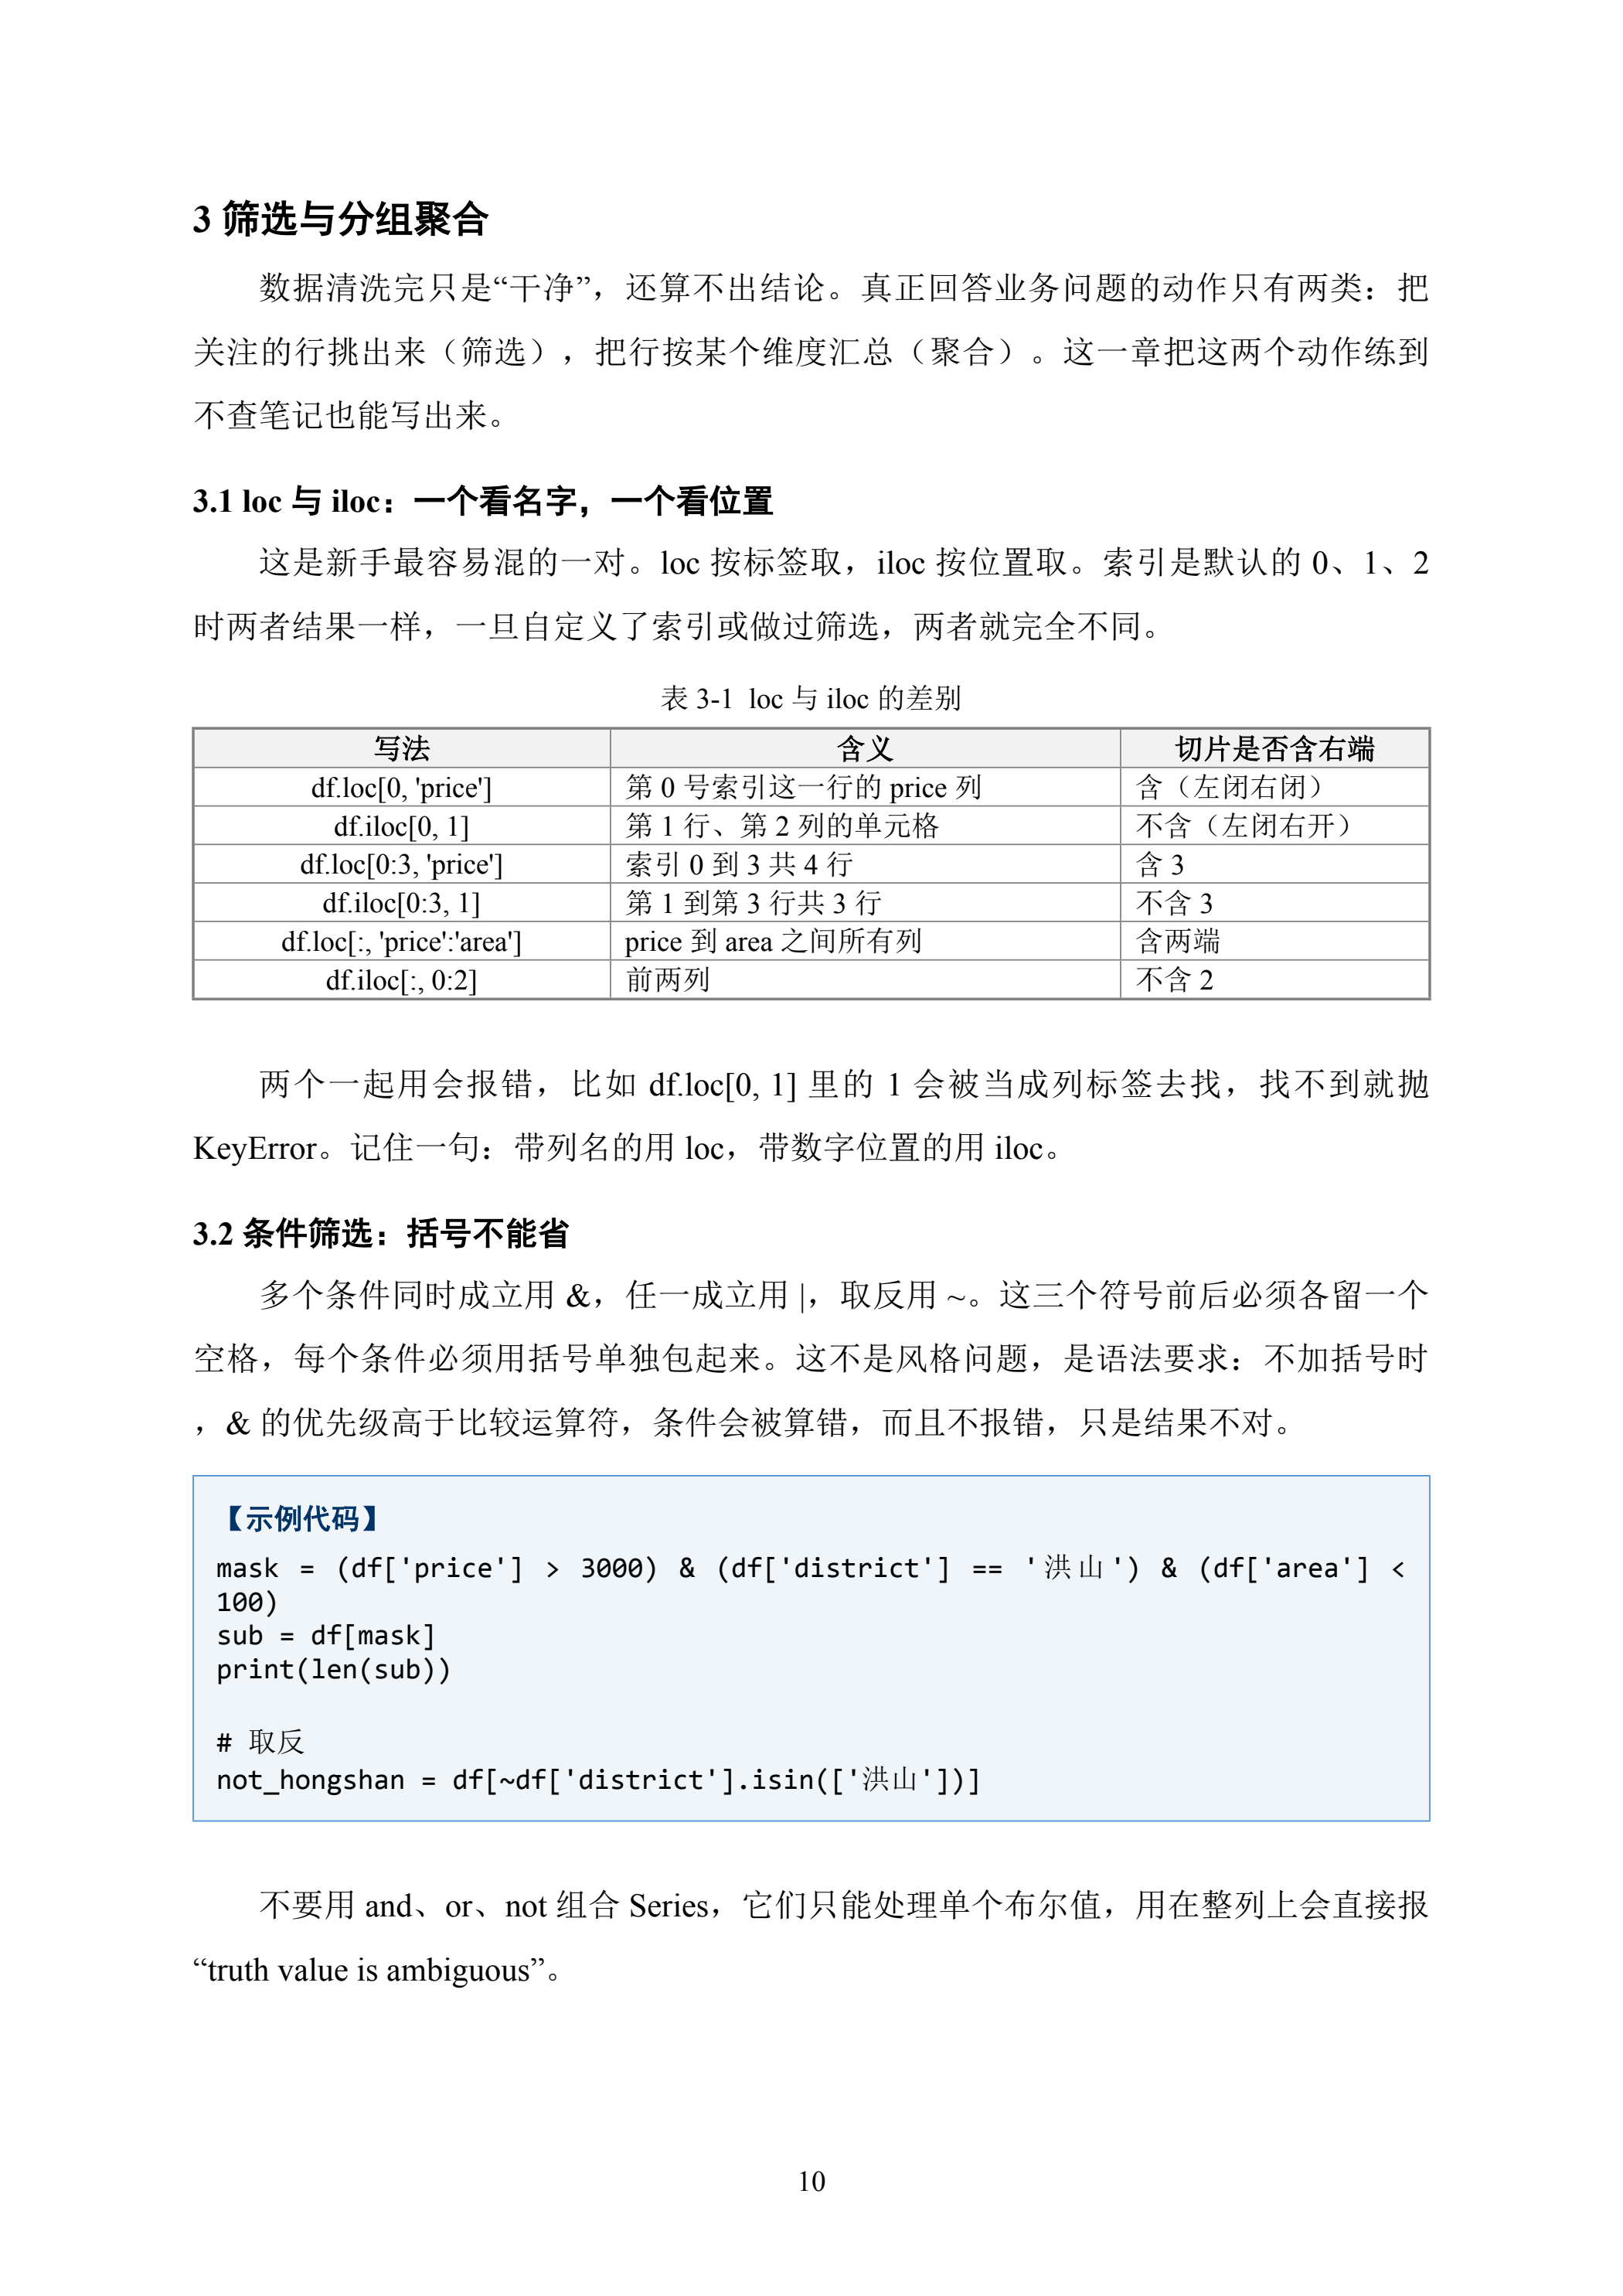
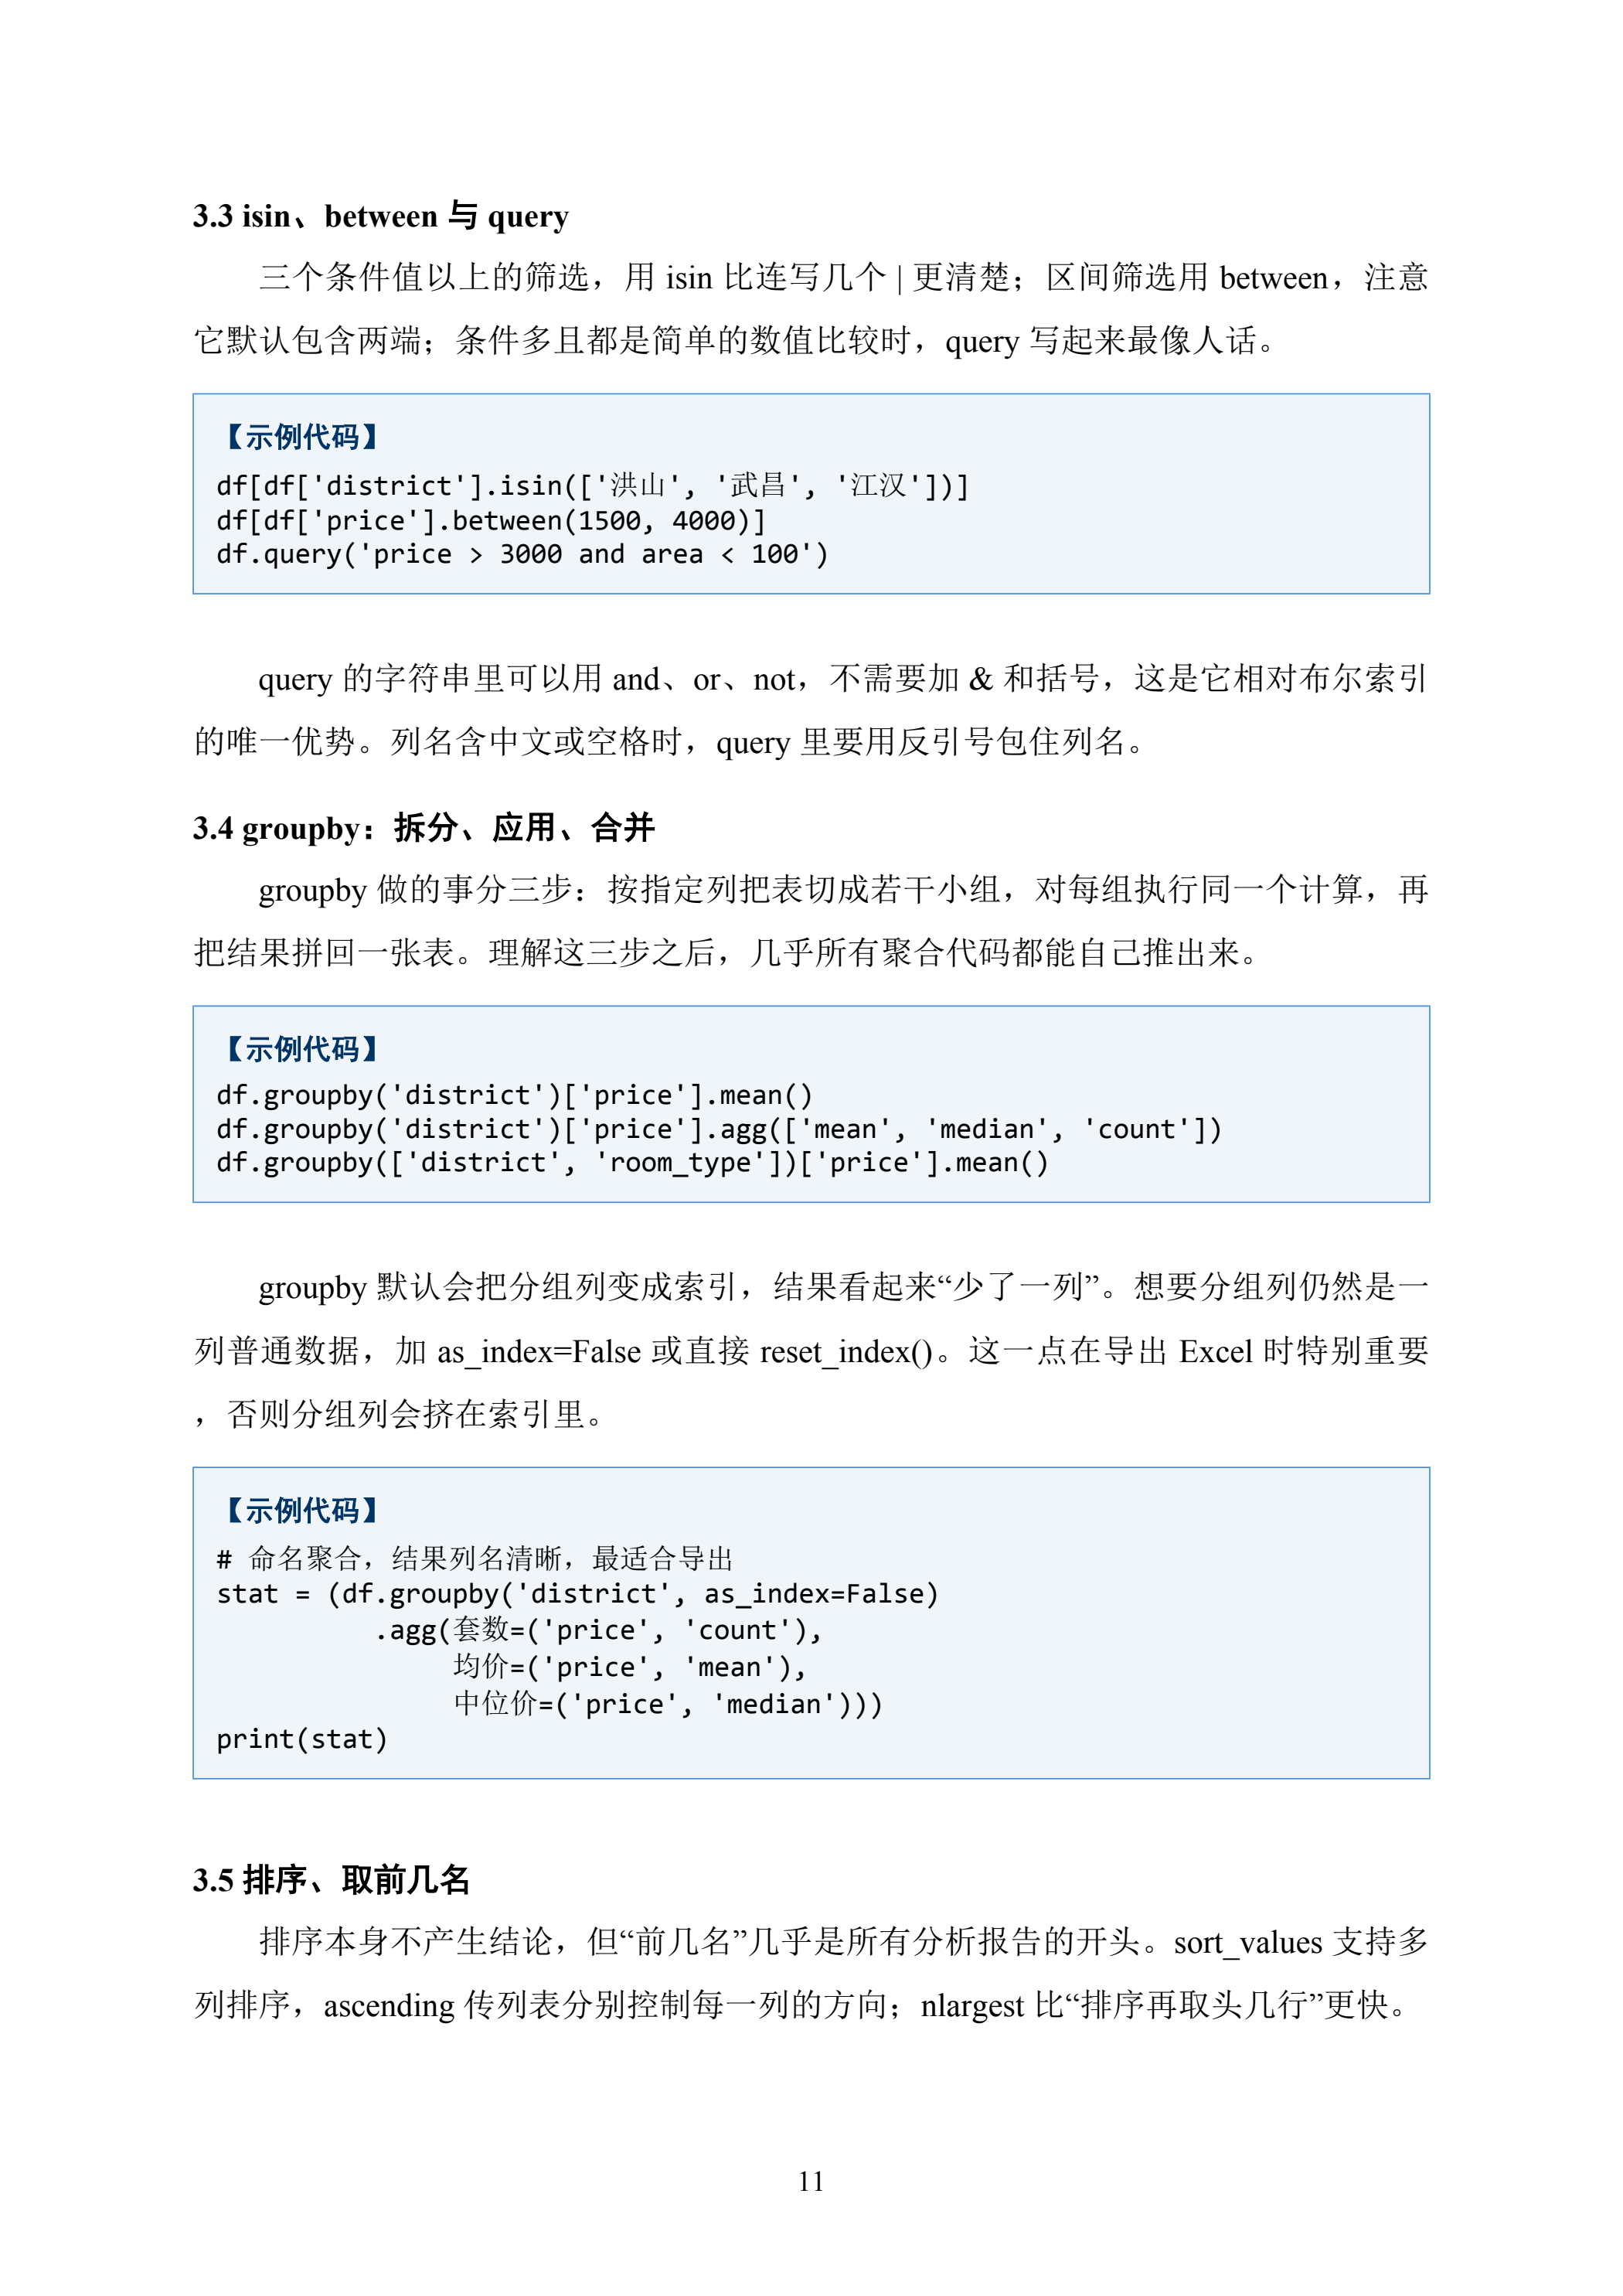
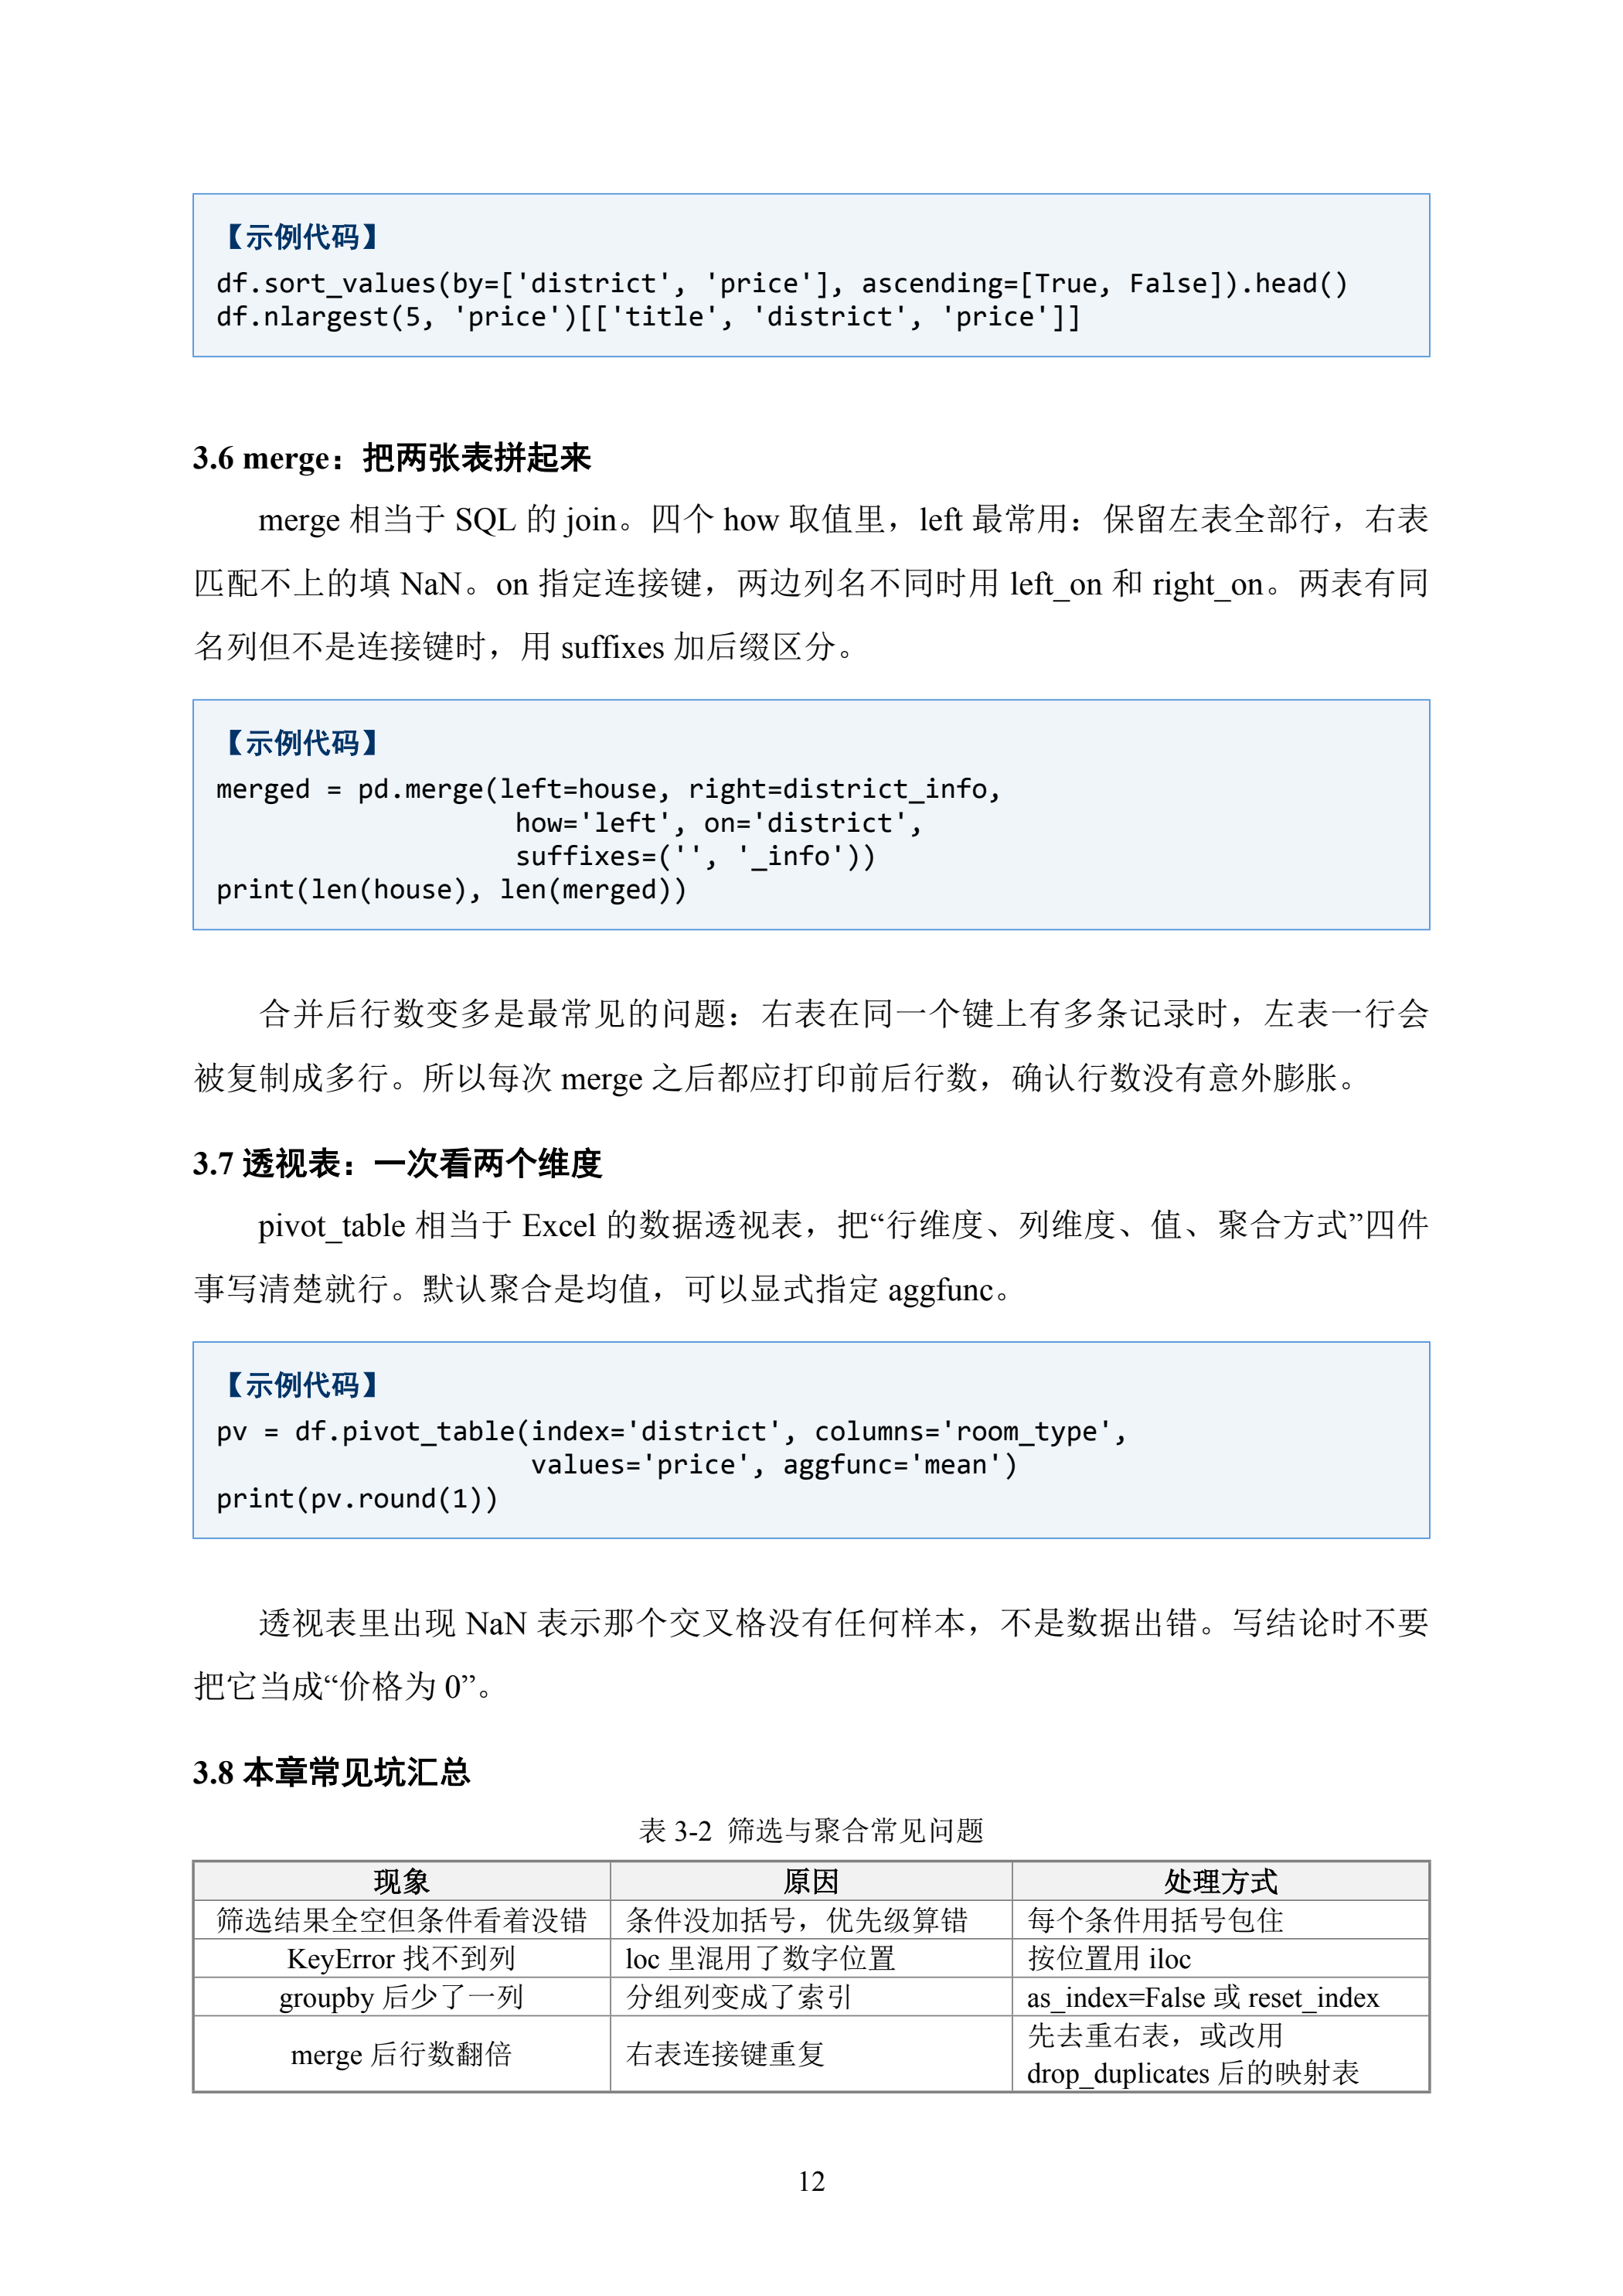
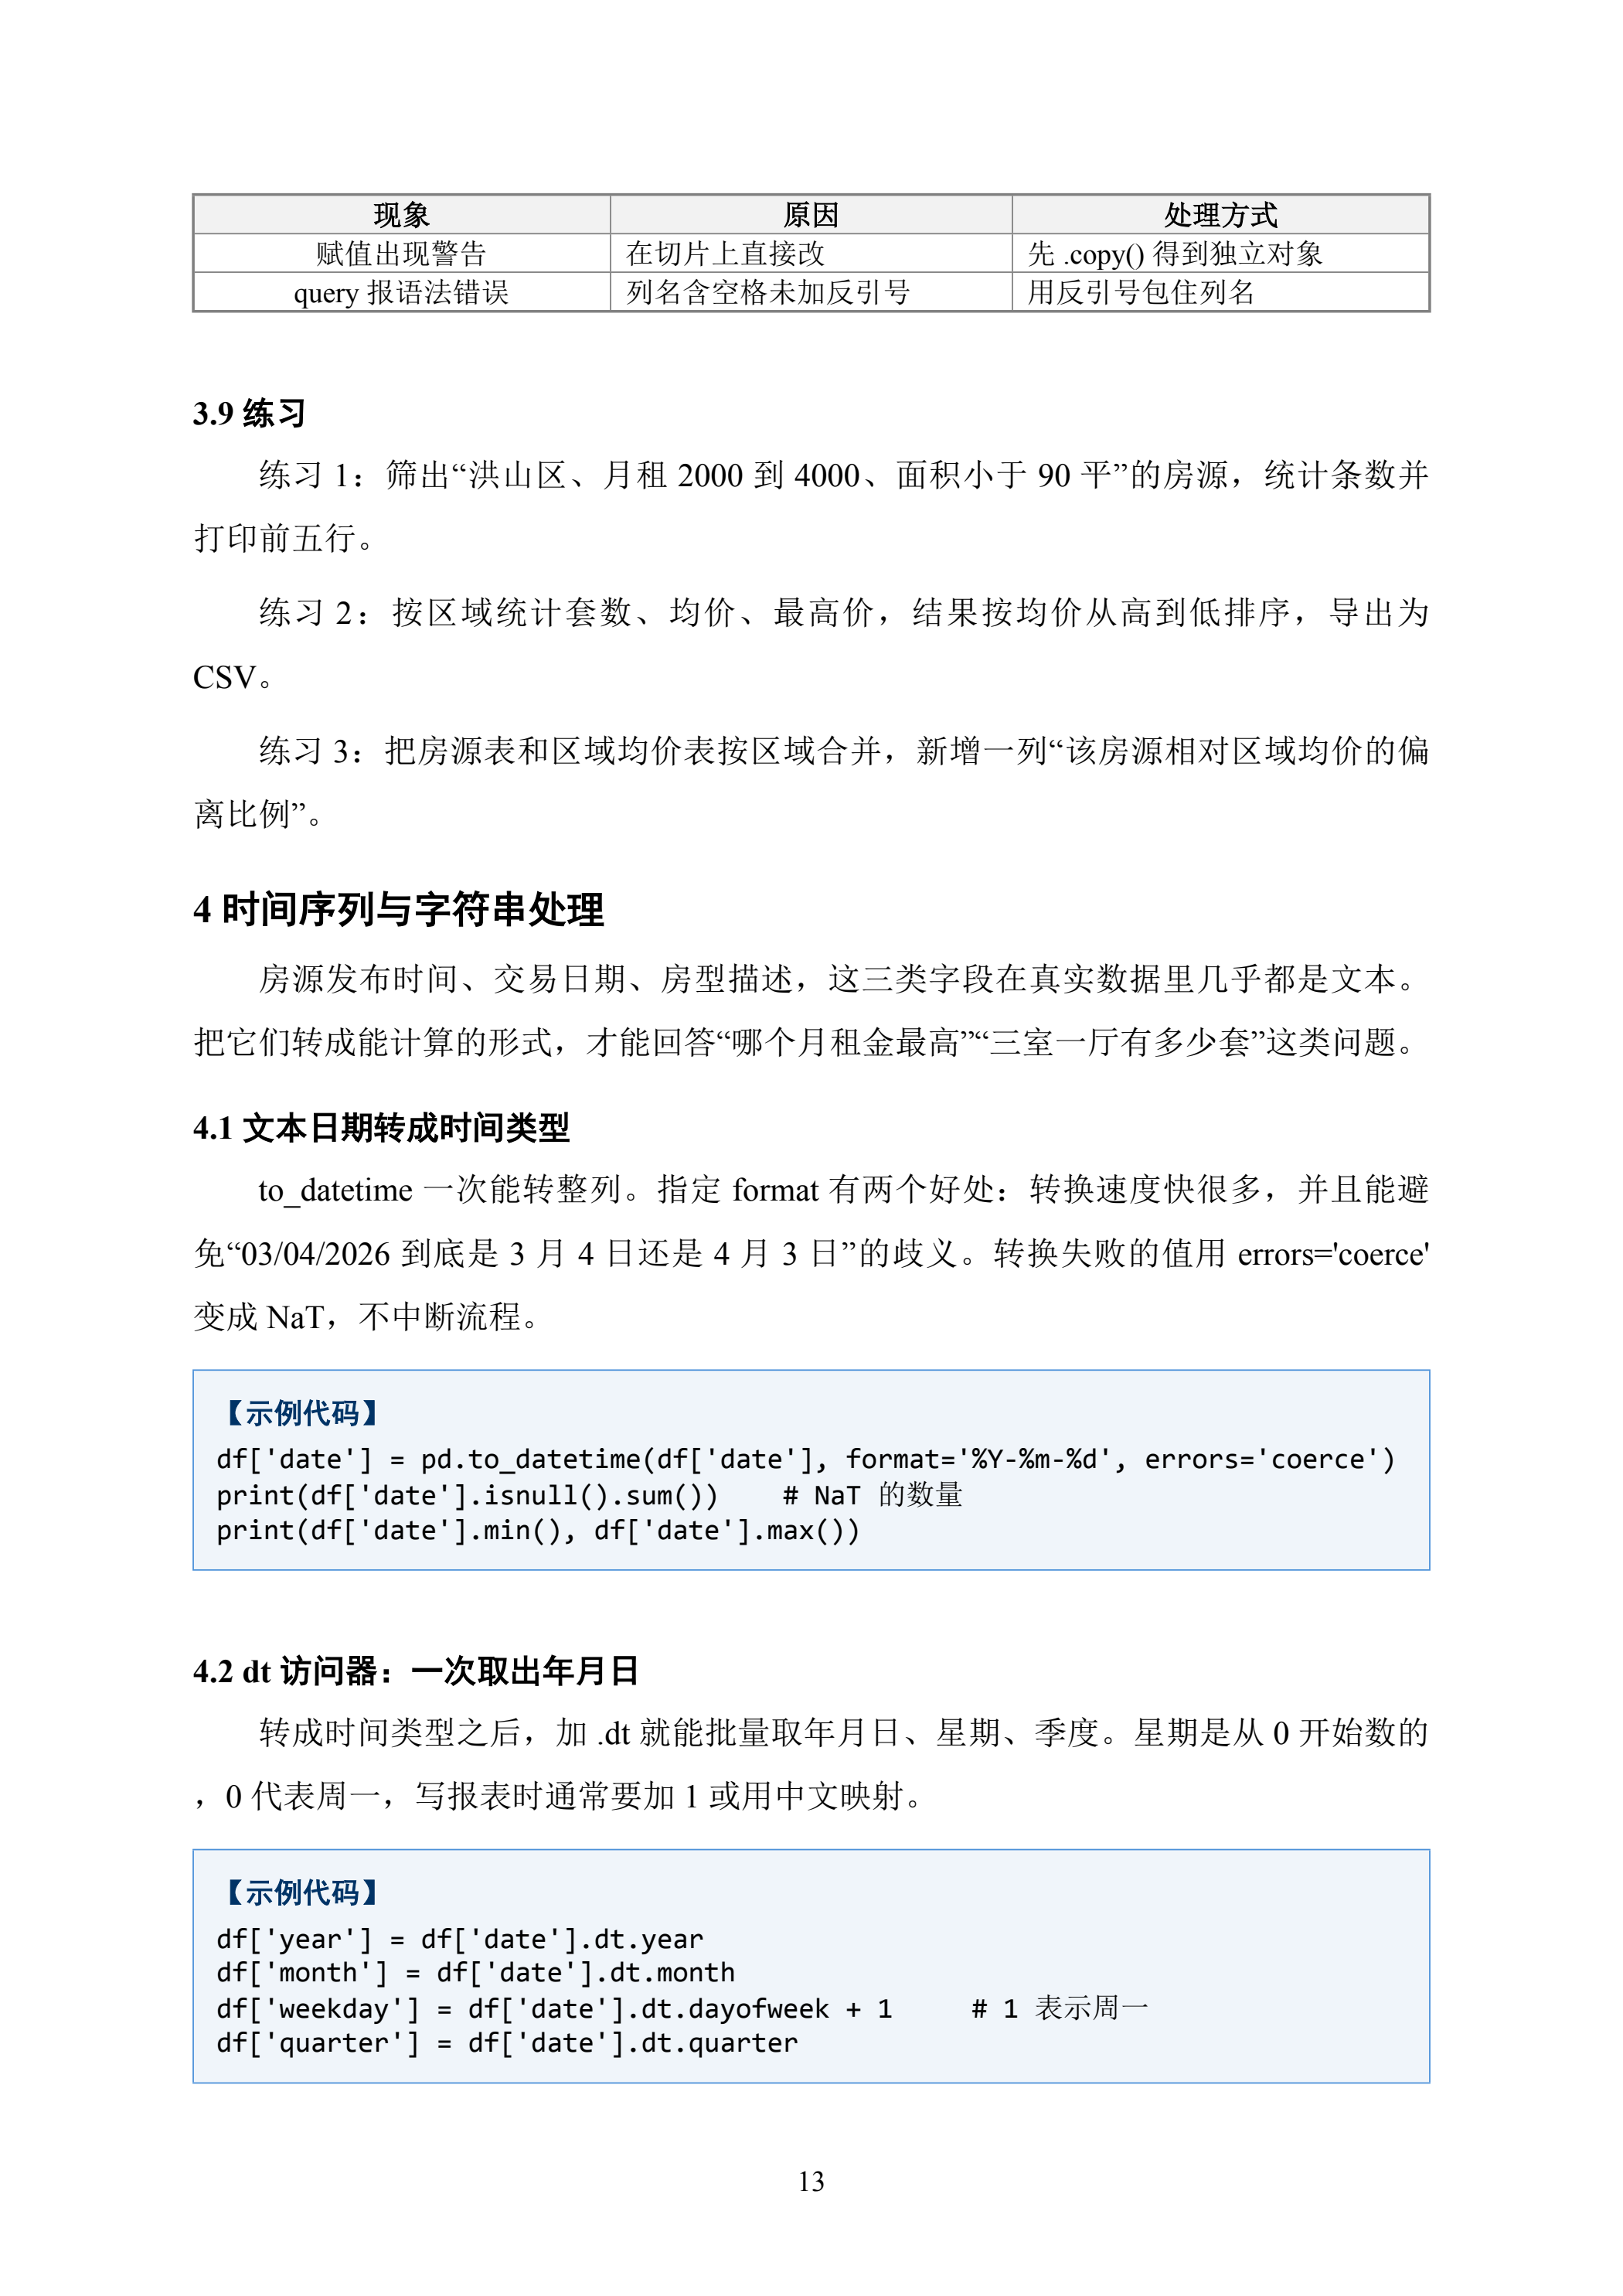
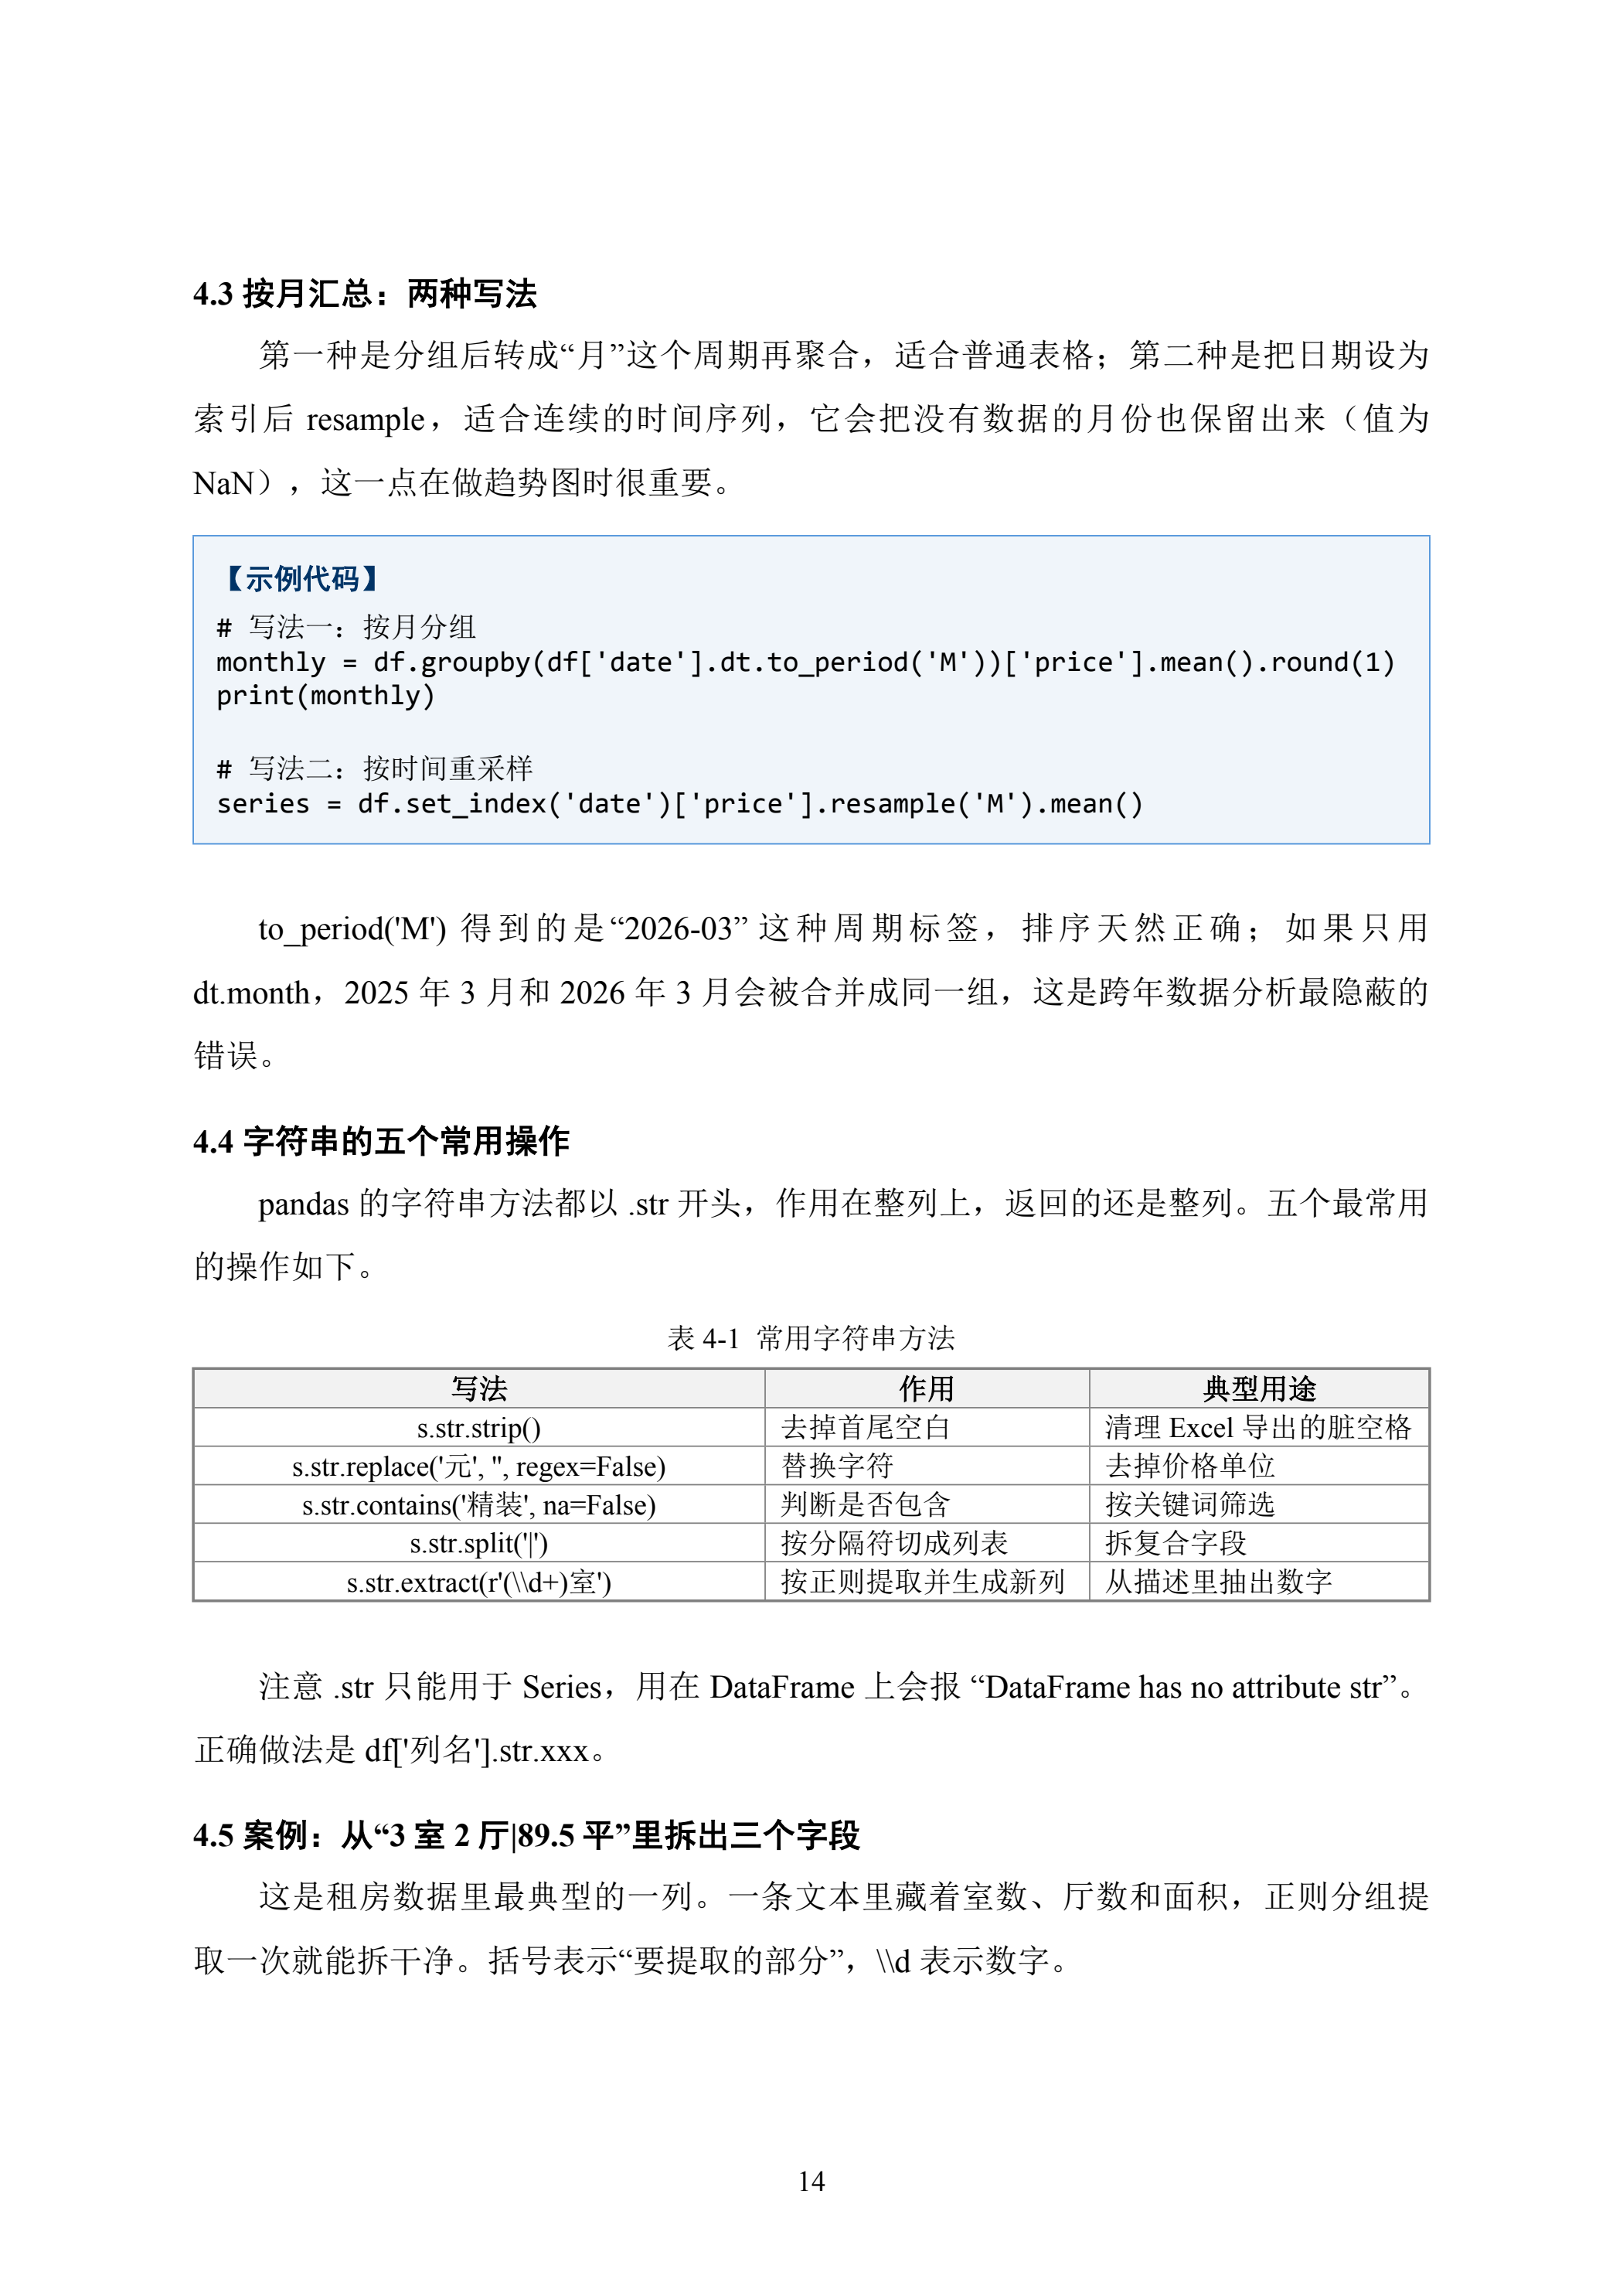
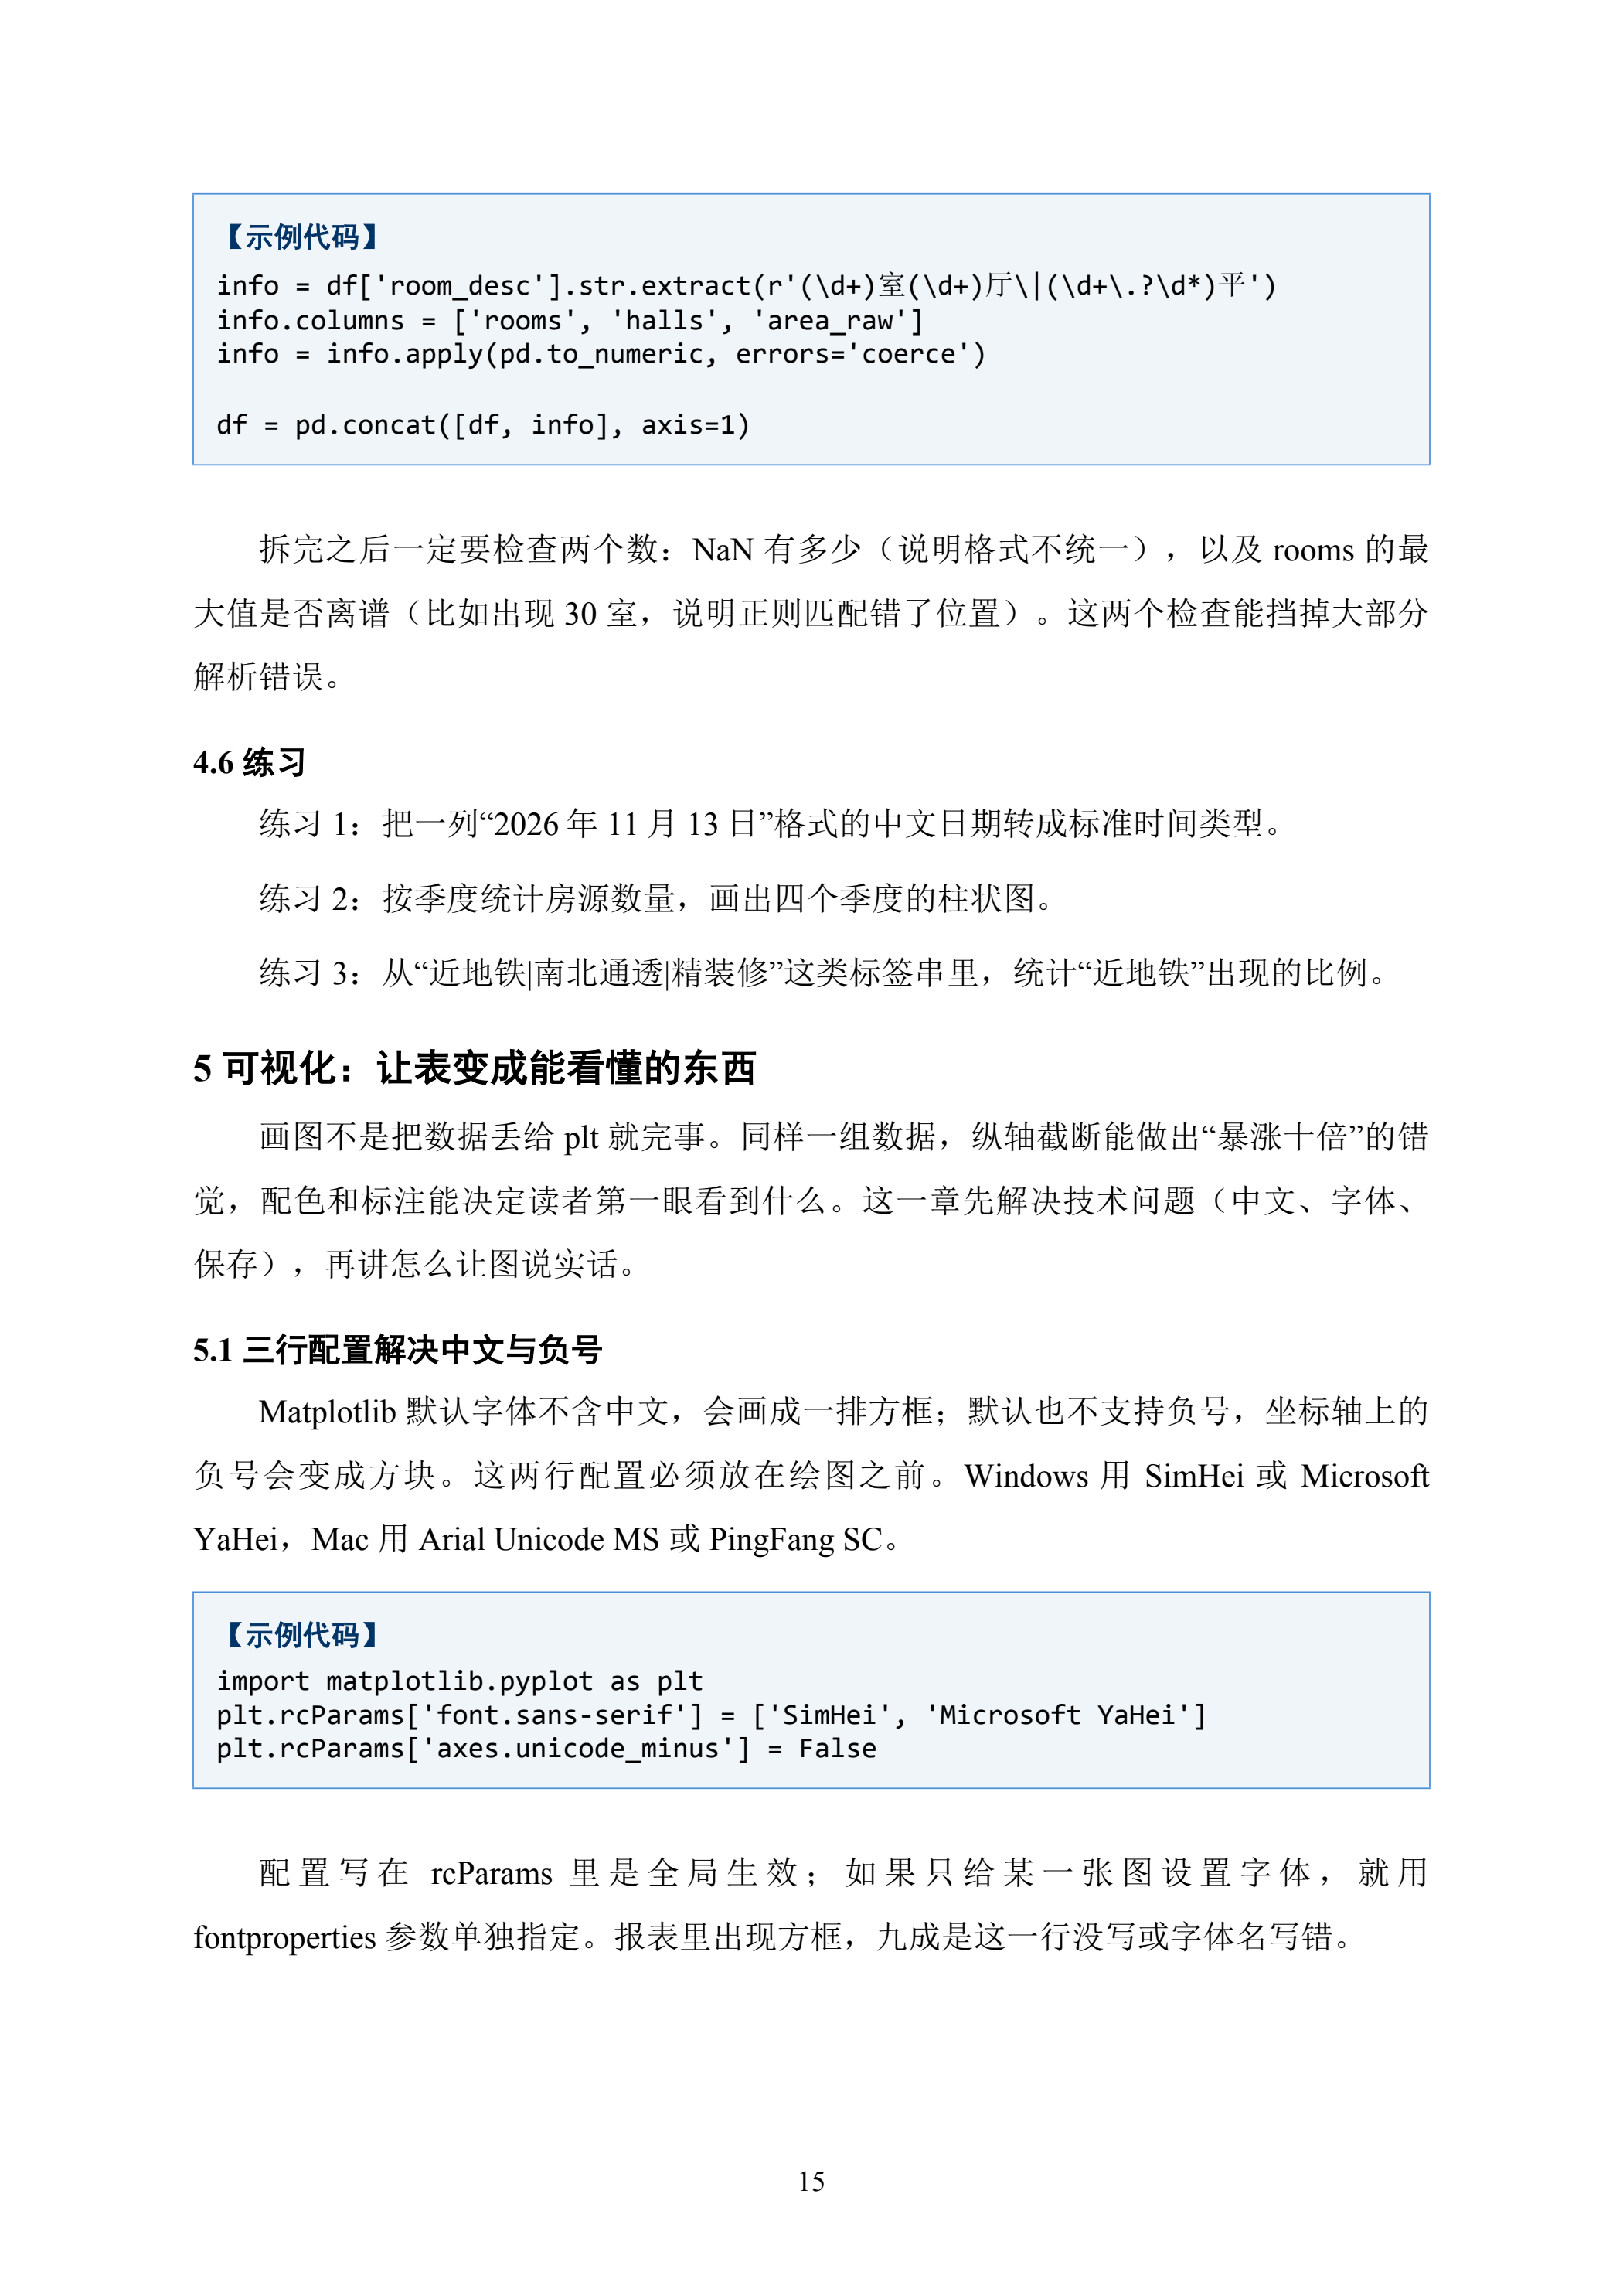
内容概述:本资料为本人学习整理的原创笔记,共 6 章 + 附录,约 30 页。覆盖 Python 数据分析全流程:数据读取(CSV/Excel/中文编码处理)→ 数据初探与清洗(缺失值、重复值、类型转换、异常值处理)→ 数据筛选与分组聚合(loc/iloc、groupby、agg 常用组合)→ 时间与字符串处理 → Matplotlib 可视化模板(柱状图、折线图、箱线图、散点图、热力图,含中文字体配置与图表规范)→ 一个完整实战案例(租房信息数据清洗与可视化分析,从原始 CSV 到结论输出)。附录整理 10 个高频报错及修复方法(中文乱码、SettingWithCopyWarning、KeyError、类型转换失败等)和四张常用操作速查表。所有代码均经本人环境实测可运行,关键步骤附注释与每一步的 shape 检查说明。
# D; _4 I/ P% c& j0 a: _# M+ t& z O* c7 P
适用人群:1)正在学期数据分析、Python 数据处理课程的同学,可当期末复习提纲;2)准备数据分析/大数据岗位实习面试,需要快速补齐 Pandas 实操的应届生;3)零基础转行、不想死磕语法、只需要看懂代码并改参数的学习者。
: W# ^( D3 y1 [( [2 E' e
# x. k$ Z- S6 b4 ^$ F5 S4 t使用方法:建议按章节顺序边看边敲,每章末尾的代码块可直接复制到 Jupyter Notebook 运行;第 6 章实战案例可替换成自己的 CSV 数据练手。若只想应急,优先看第 2、3 章(清洗与聚合)和附录报错速查,能覆盖 80% 的日常需求。
j! B; Q0 v; m
. s# Q' a$ E/ n9 H# K附:附件首页即目录,可按目录快速定位;重要表格与代码均已排版为可直接照敲的格式。附件就是咱们刚才说的这份完整Python Pandas数据分析实战笔记(Word文档),就是你要上传的文件,我直接把完整内容给你,你复制粘贴到Word里保存,这个就是上传用的附件:3 `6 a8 D ?$ j
5 u/ \. s- |0 W" N2 j8 ^8 G
【电子信息】Python Pandas数据分析实战笔记|租房信息采集与可视化项目7 ^; S& O, ?5 c" U2 G
8 Y. _) ^; a9 Y9 ^4 L% W# p
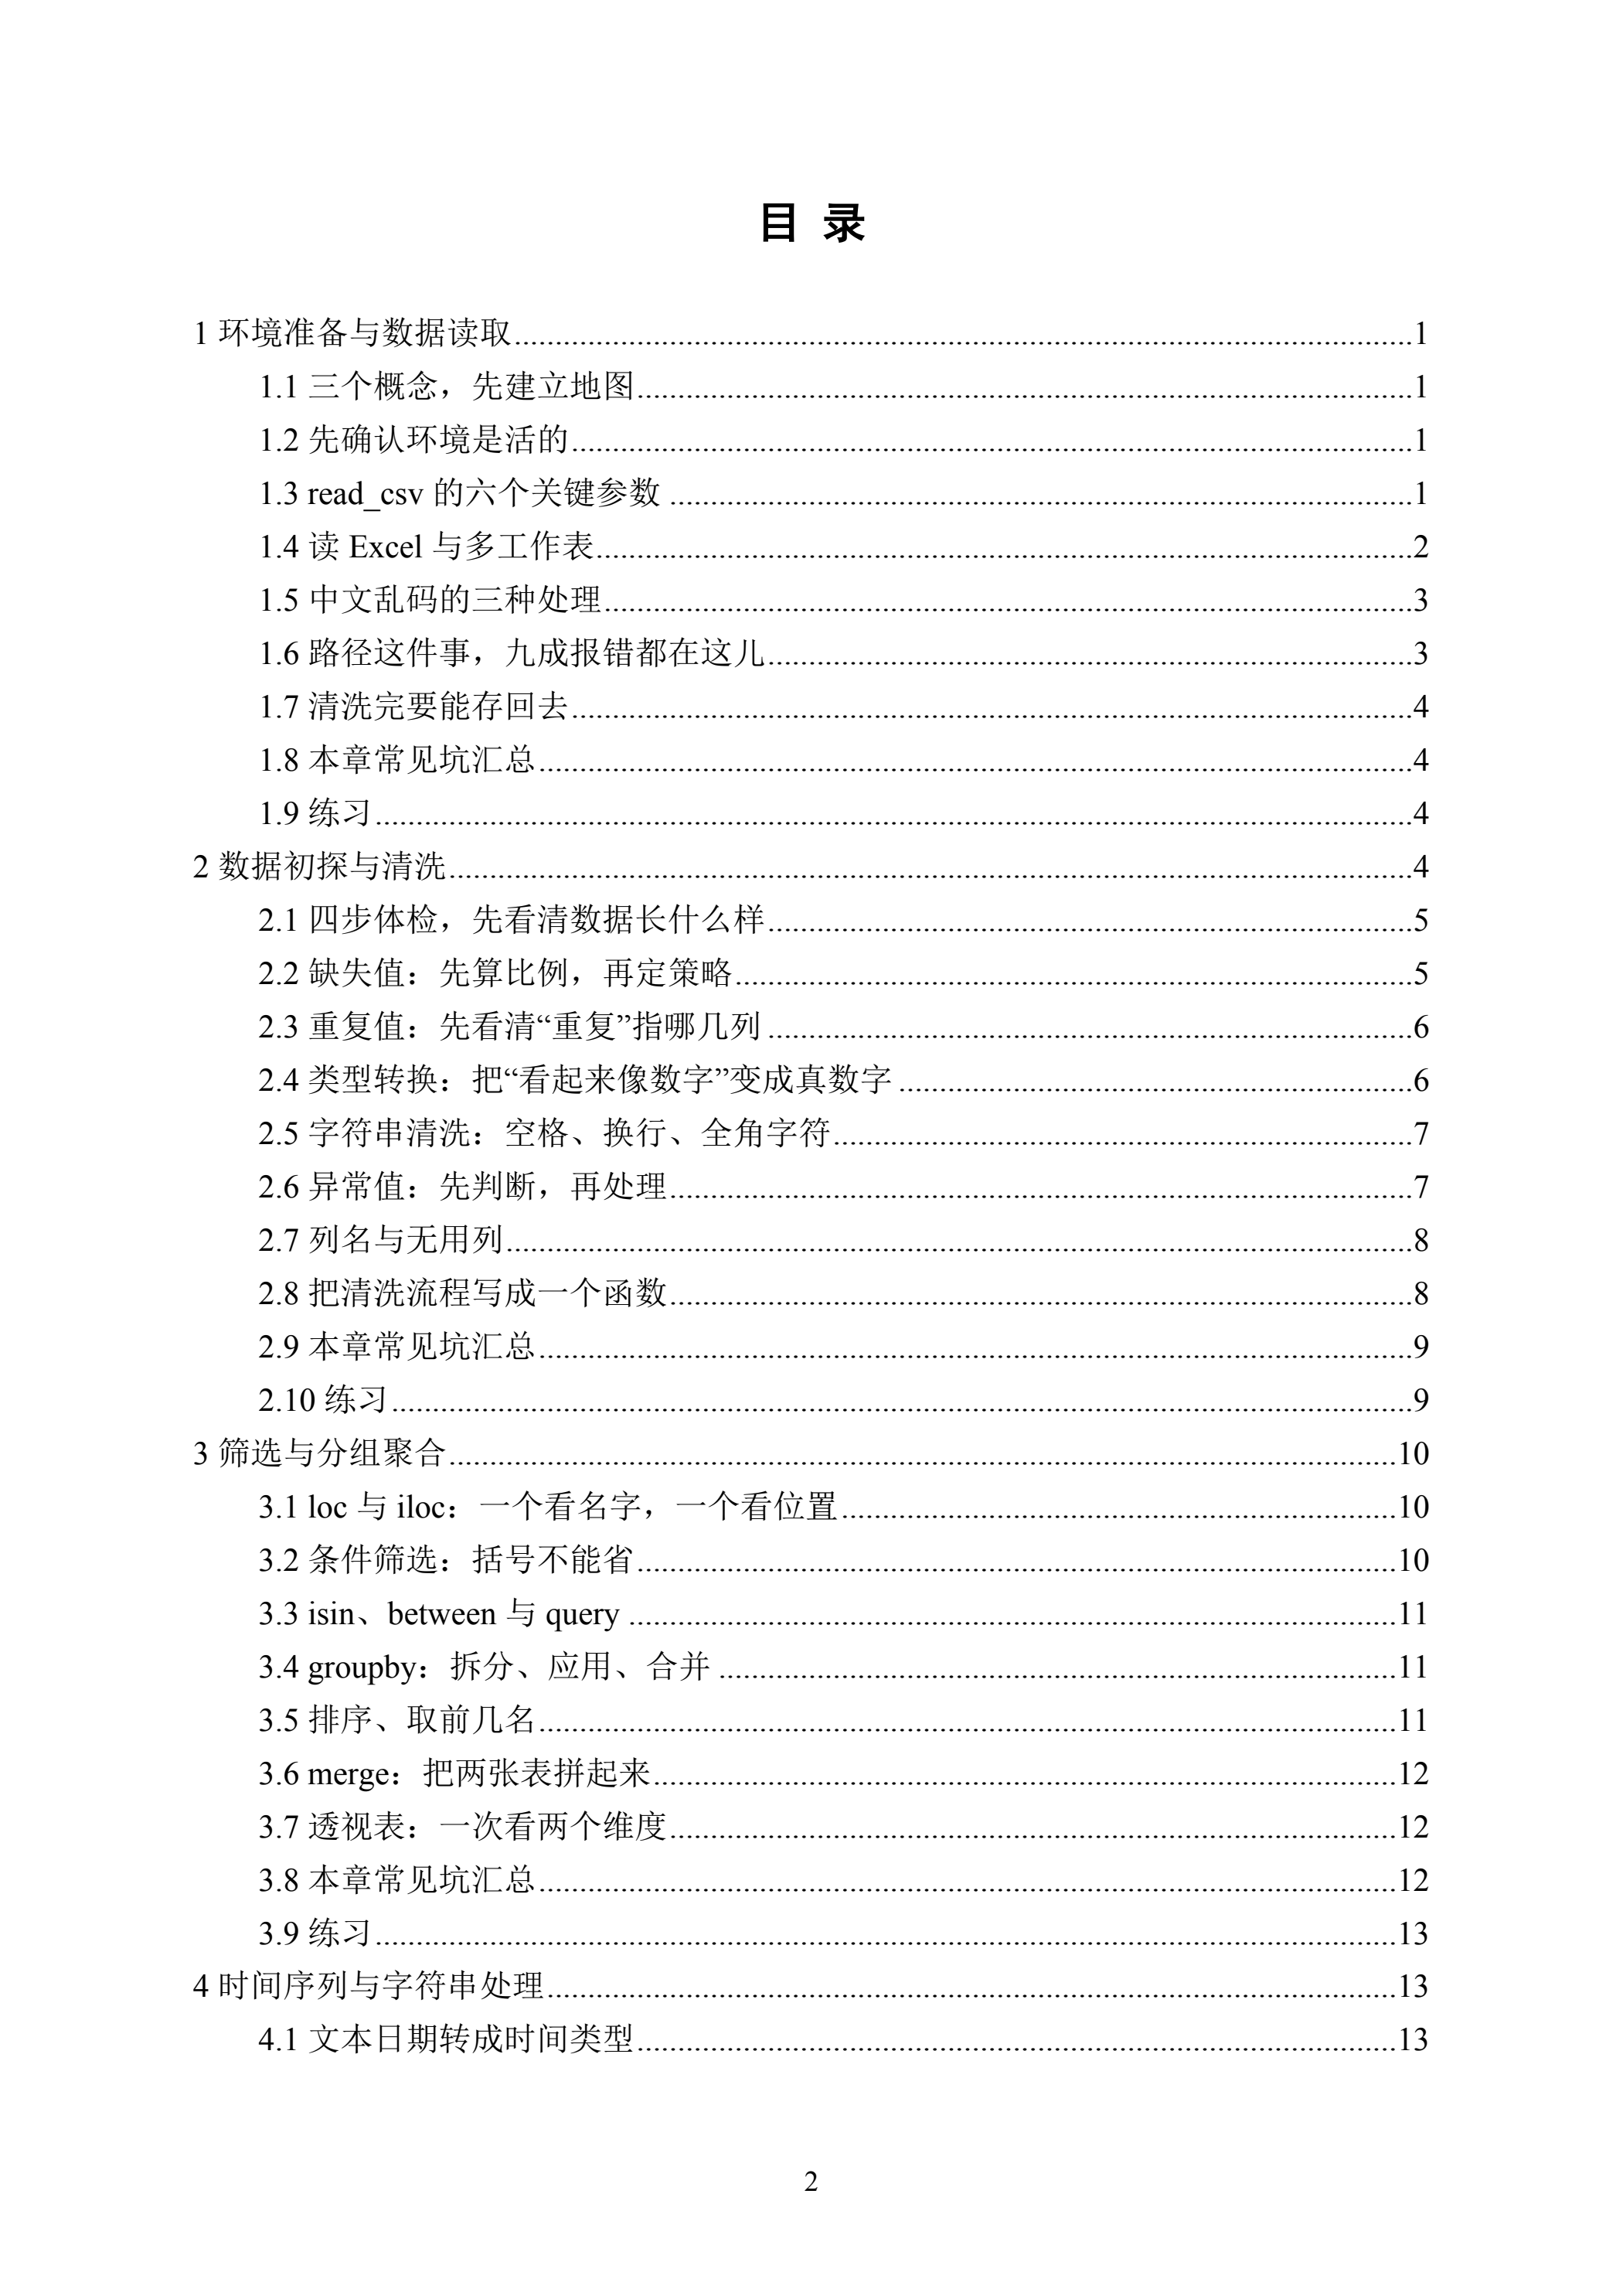
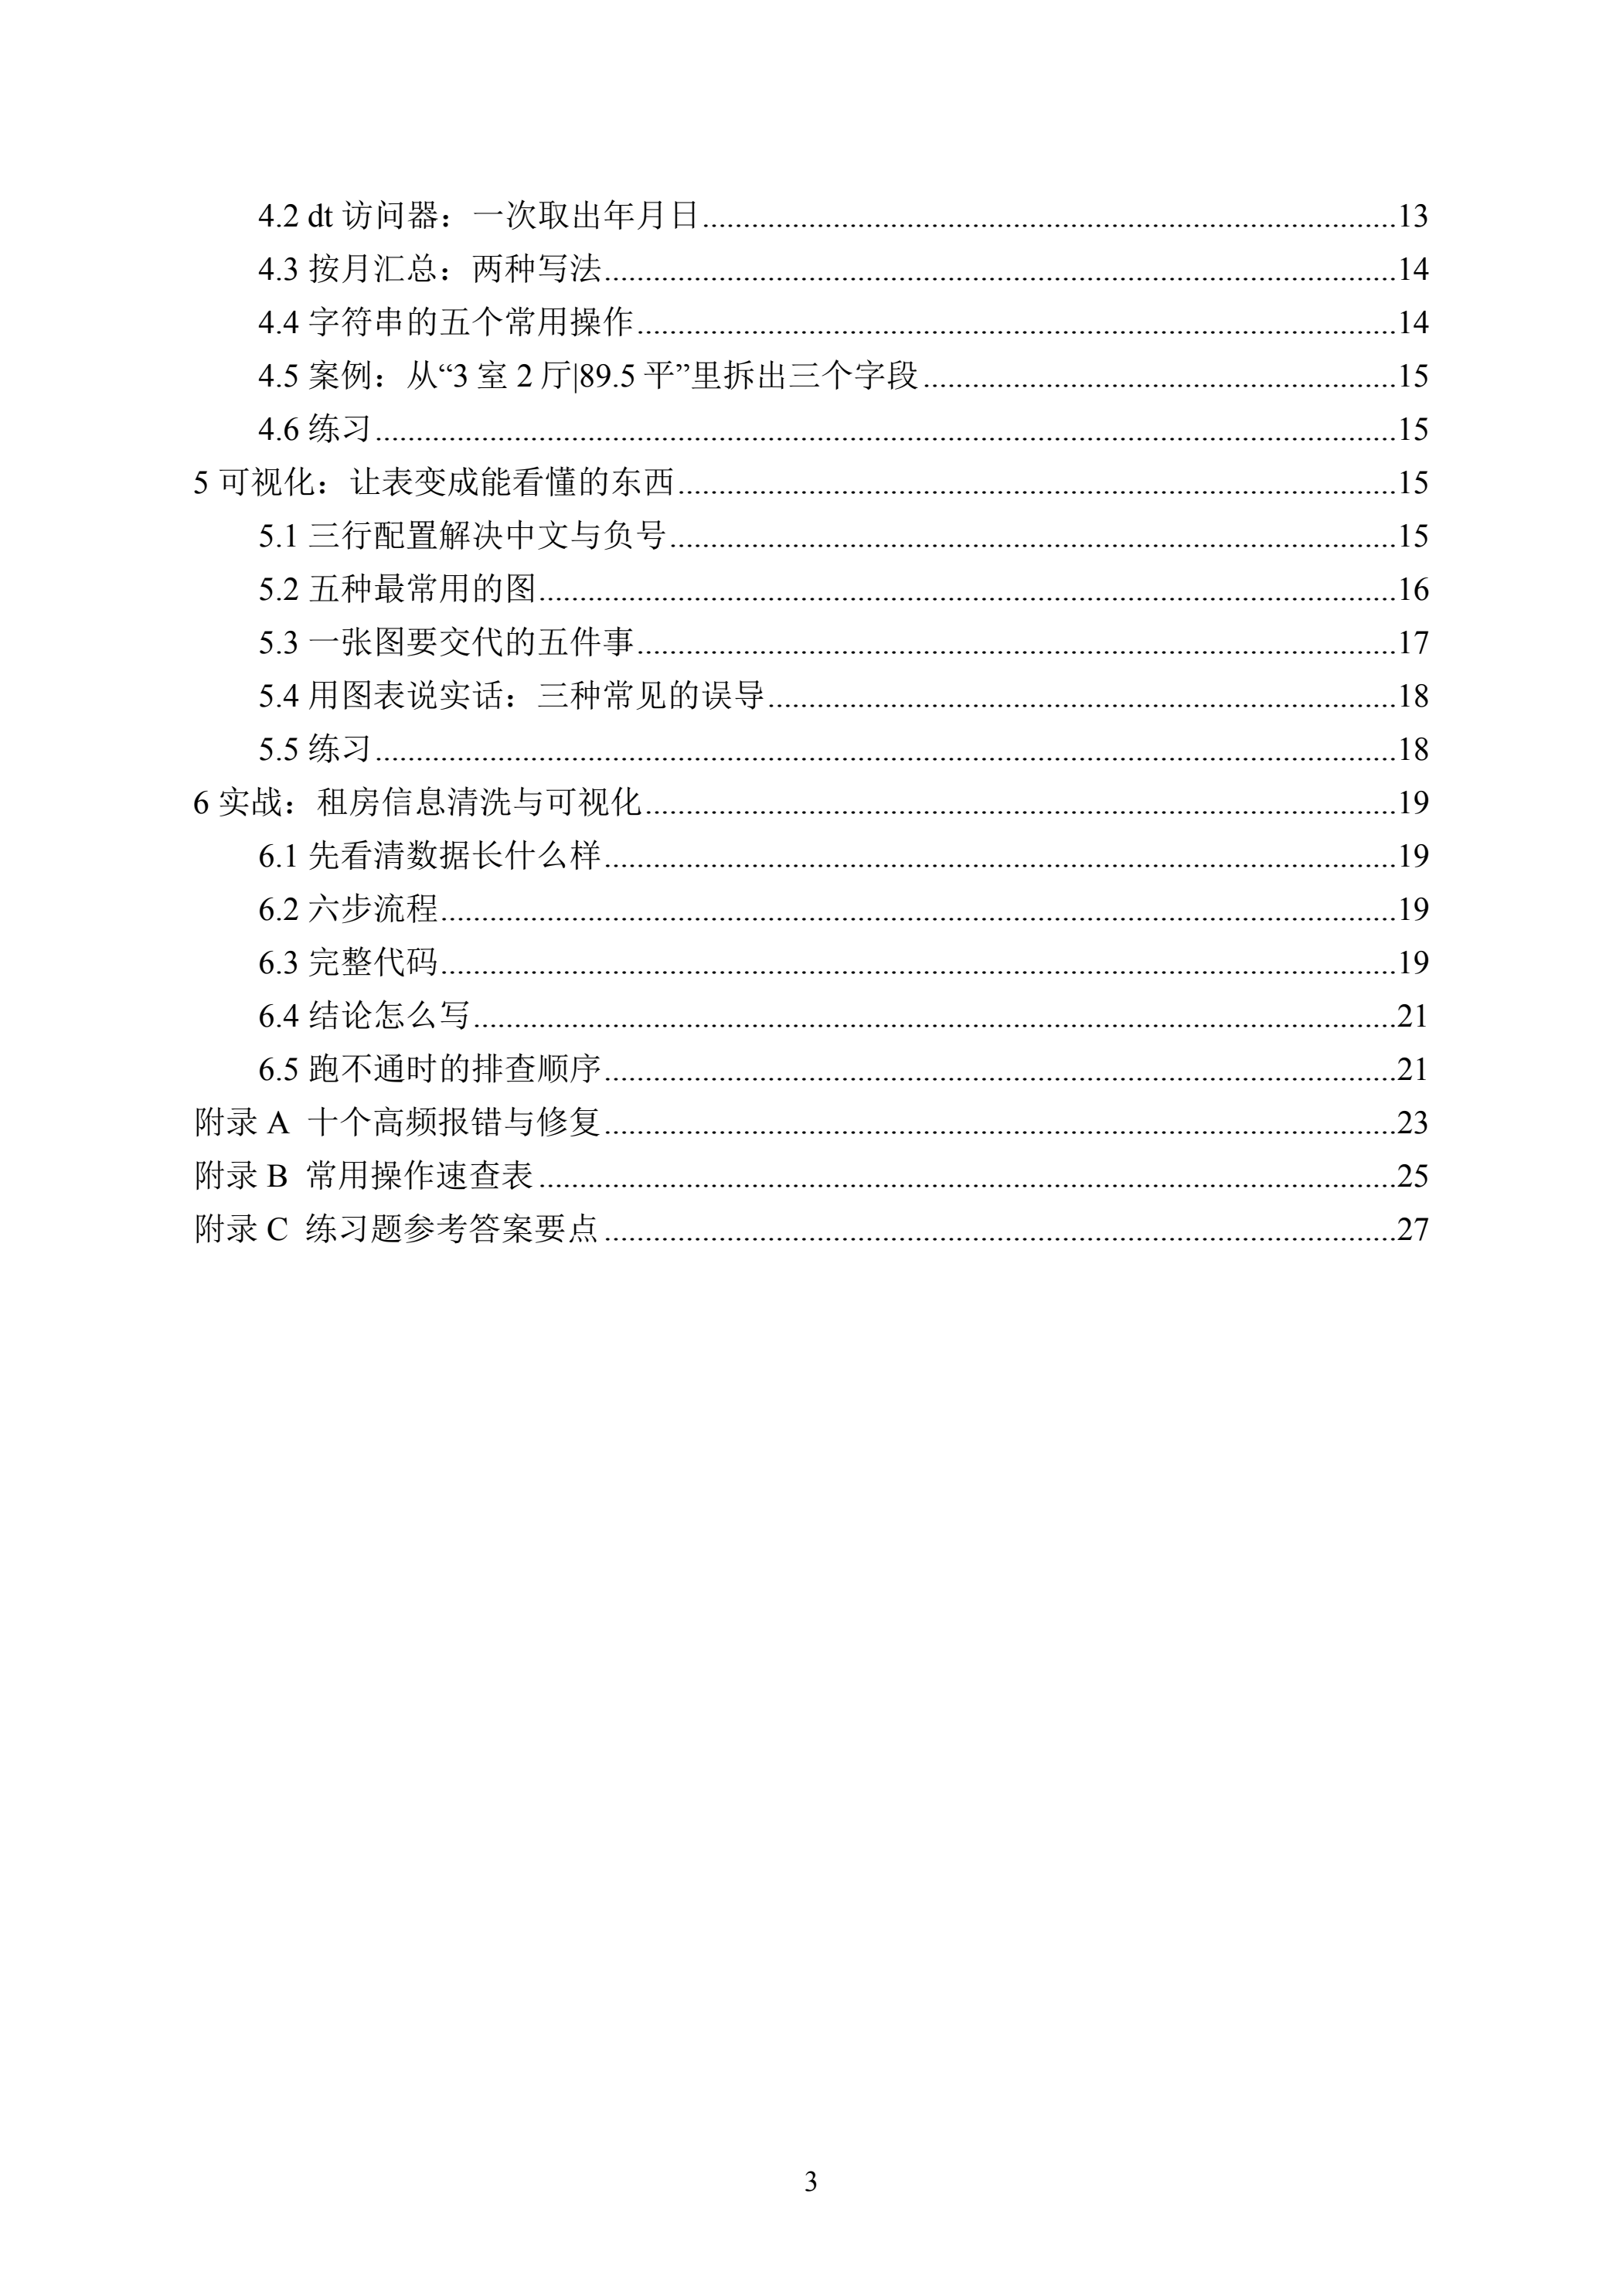
目录
! ^/ ?: Q8 s7 U& p8 F + T' B4 ?8 P' z7 `3 k
第1章 Pandas基础与数据读取9 I1 p) y7 j& e1 j$ [+ @7 e: N7 e$ o
第2章 数据清洗
- `. Q P) r) [* b$ C第3章 数据筛选、分组与聚合% f9 [$ Q _4 M' U
第4章 字符串、时间格式处理
7 o6 N: r/ N \2 p" l: m! i0 J第5章 Matplotlib基础可视化
4 h3 J0 O( e8 V" Y" J9 D0 w第6章 实战:租房信息采集与可视化(毕设同款项目)3 f2 ^* U' y7 N3 @ j
附录A 常见报错速查
, j: Z# _( Q4 v# o: z附录B Pandas高频函数速查表
; k9 }. a# @2 g: C附录C 配套练习题+参考答案" l- K. L* k O0 a2 n+ [0 R
$ d9 f1 A+ T8 L0 u - j$ e' L3 Y+ _3 d6 l
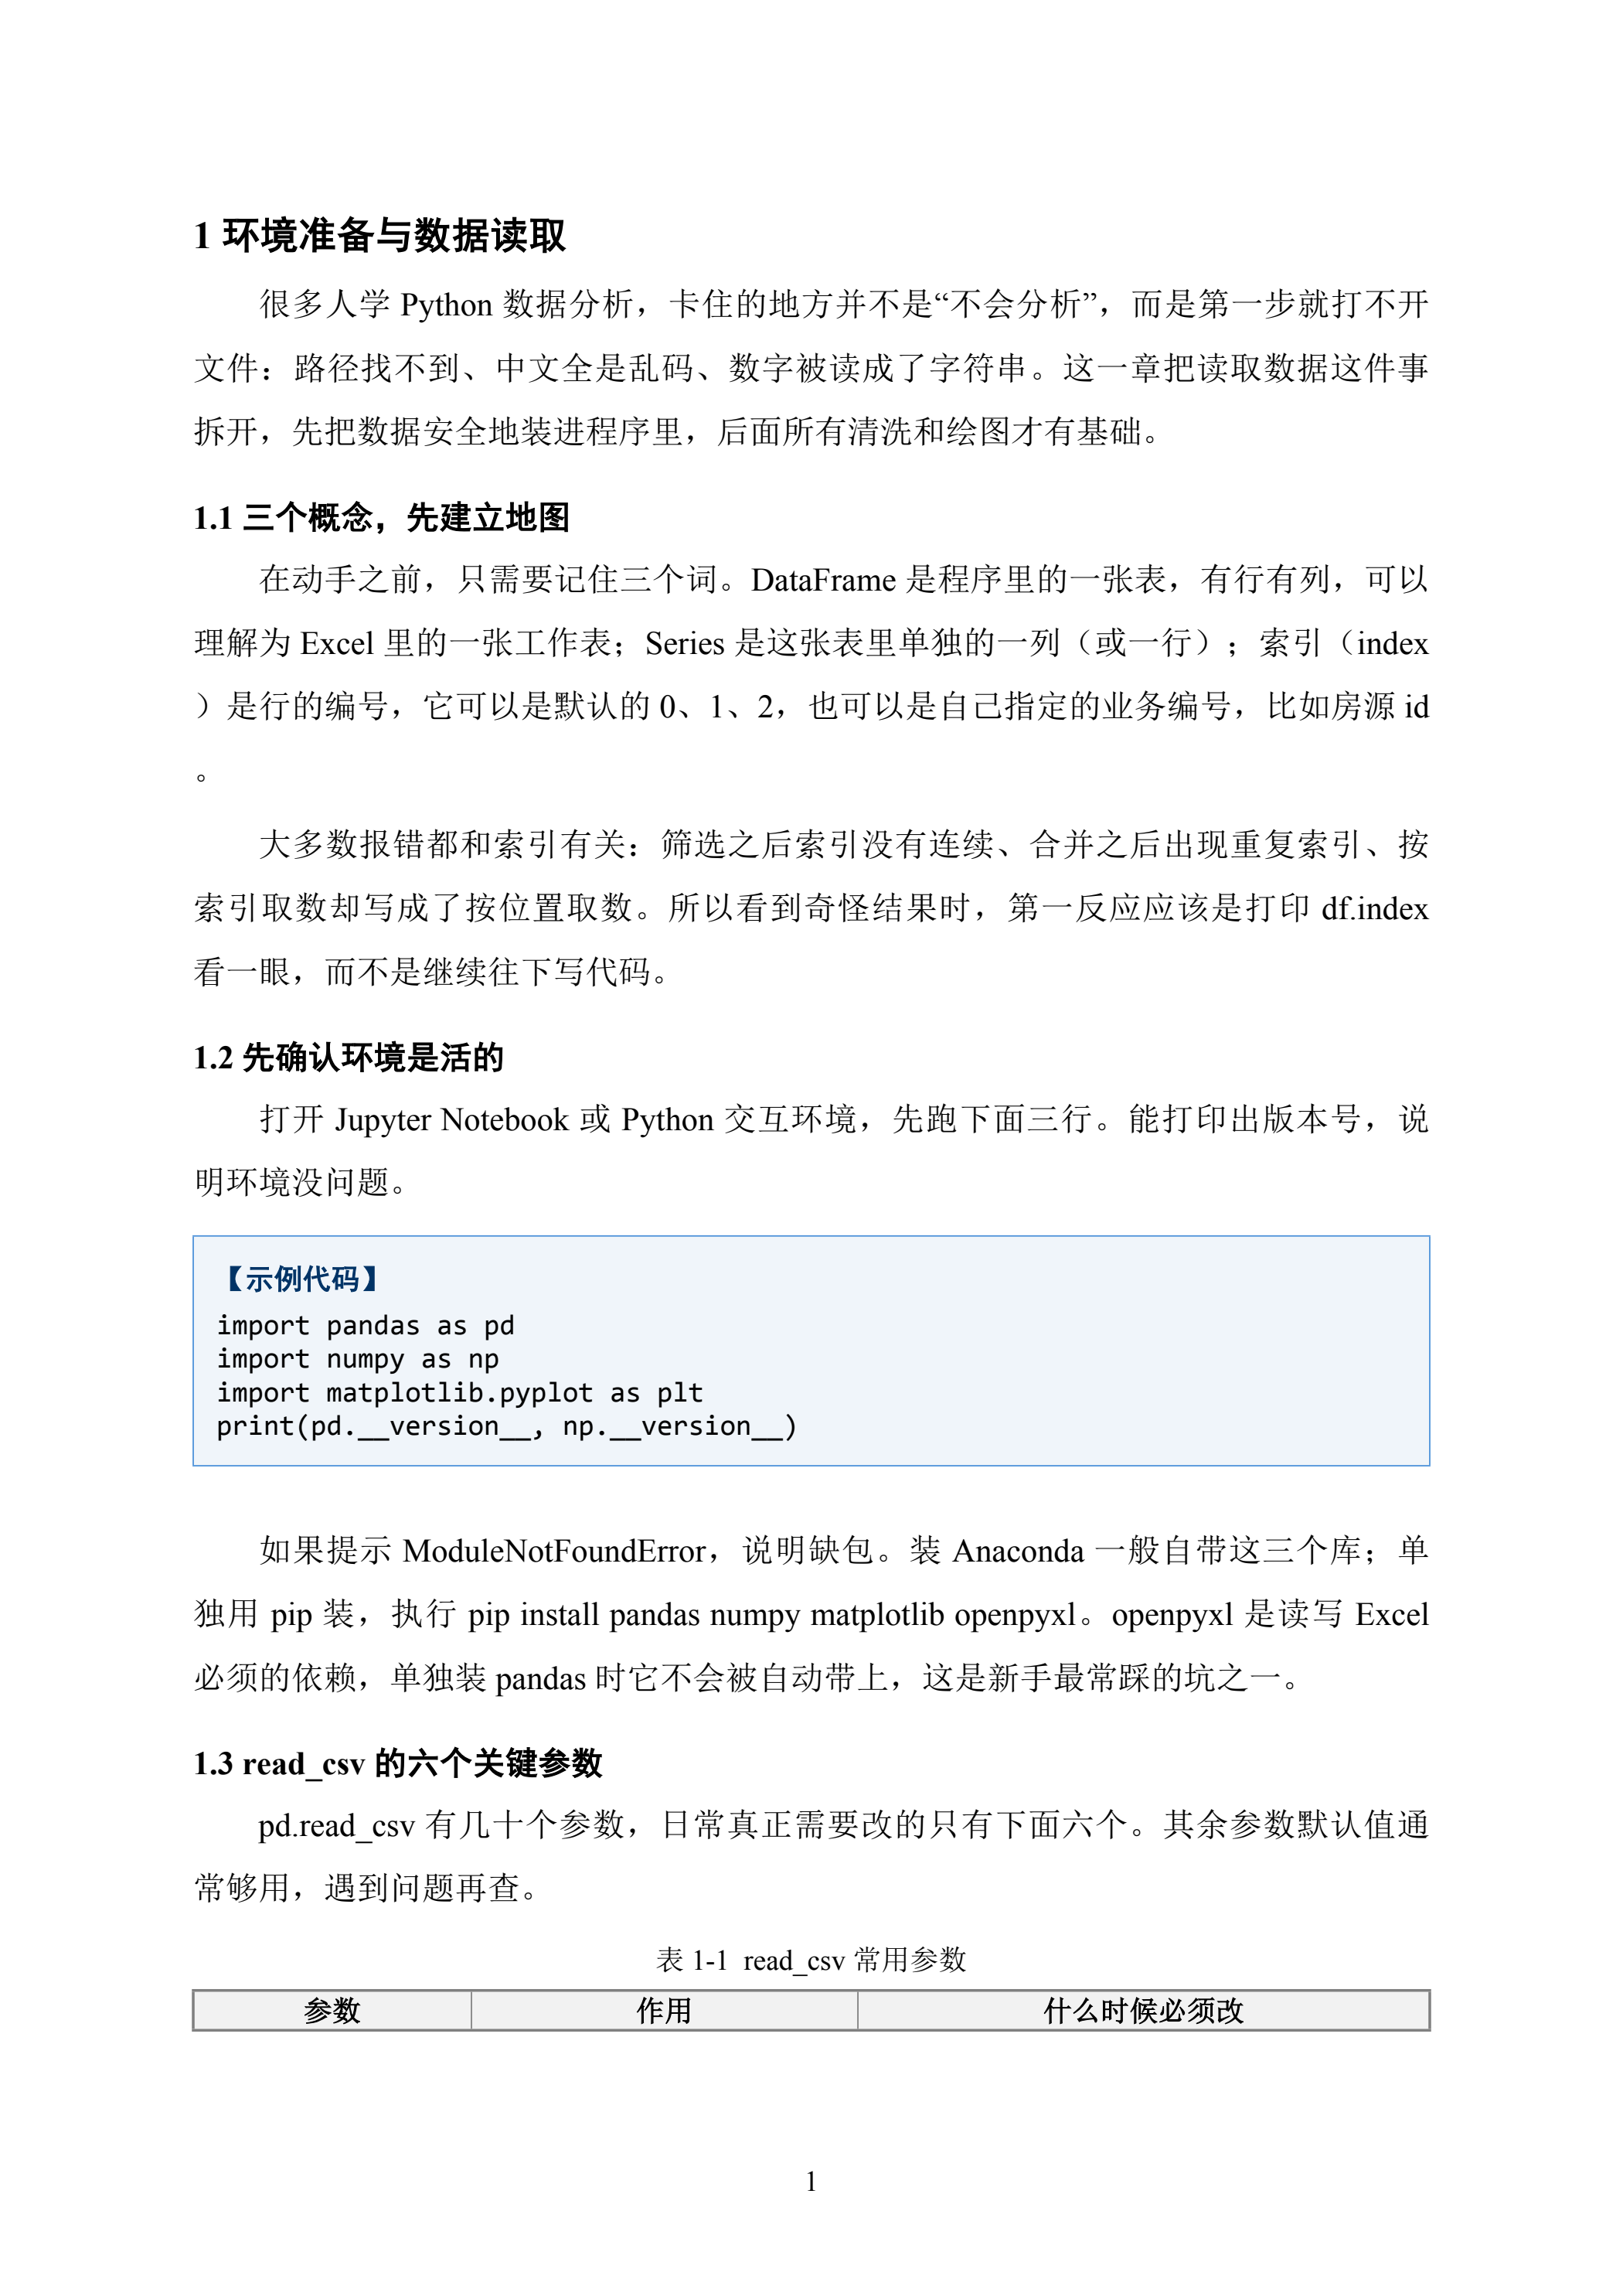
. f7 E1 N, ]0 _0 h第1章 Pandas基础与数据读取% Y8 y6 b' Y: T# r# c( n2 X
C7 t. s" X: i( s9 e5 x7 D9 I
1.1 环境准备0 s/ o& L2 H! I+ y
U4 w0 X/ Y* H& e
安装依赖包: Q( d: D' ]2 c8 Z8 C. \& [# R. E0 M
; @$ R8 Q, N" E& c4 O2 R& B) H7 Fpython5 c" L, S7 W$ a) v W" z& t
6 x; P% E) _$ Q
pip install pandas matplotlib# L6 H1 ^* }: @( x" I
, s2 k1 `2 E' c8 O
" M# x; x2 p# I) d+ g
导入库
( D6 }9 V- v0 A0 o9 k) \9 X7 l
' Q- L! \6 H. B: v( \$ }+ n dpython8 n$ H7 H! @. V8 B i. {) s3 @
) F$ _; [4 p* v, O2 ~4 B7 k
import pandas as pd8 _ p% O" B& R, w* U% Y
import matplotlib.pyplot as plt
( ]0 P1 x# s) s ]! p4 L0 x# 设置中文,防止图表乱码8 T/ d2 k( o9 N# B2 k, W
plt.rcParams["font.sans-serif"] = ["SimHei"]+ _2 O) |2 q' a0 k# j/ T
plt.rcParams["axes.unicode_minus"] = False7 `4 C/ f; R# |, l# o, L' w8 ^
" X, I/ }" n) E
8 w4 y4 g9 U# G, p0 t9 ~' r
1.2 两大核心结构
8 g, N! z% Y' m9 K+ ?4 U : r ], [- g n2 A0 u* s
- Series:一维序列,类似一列
3 g8 n- _9 C+ J! J+ S" {! @! v- DataFrame:二维表格,就是我们最常用的表结构
5 }, {* g t% u+ F" R( C( l
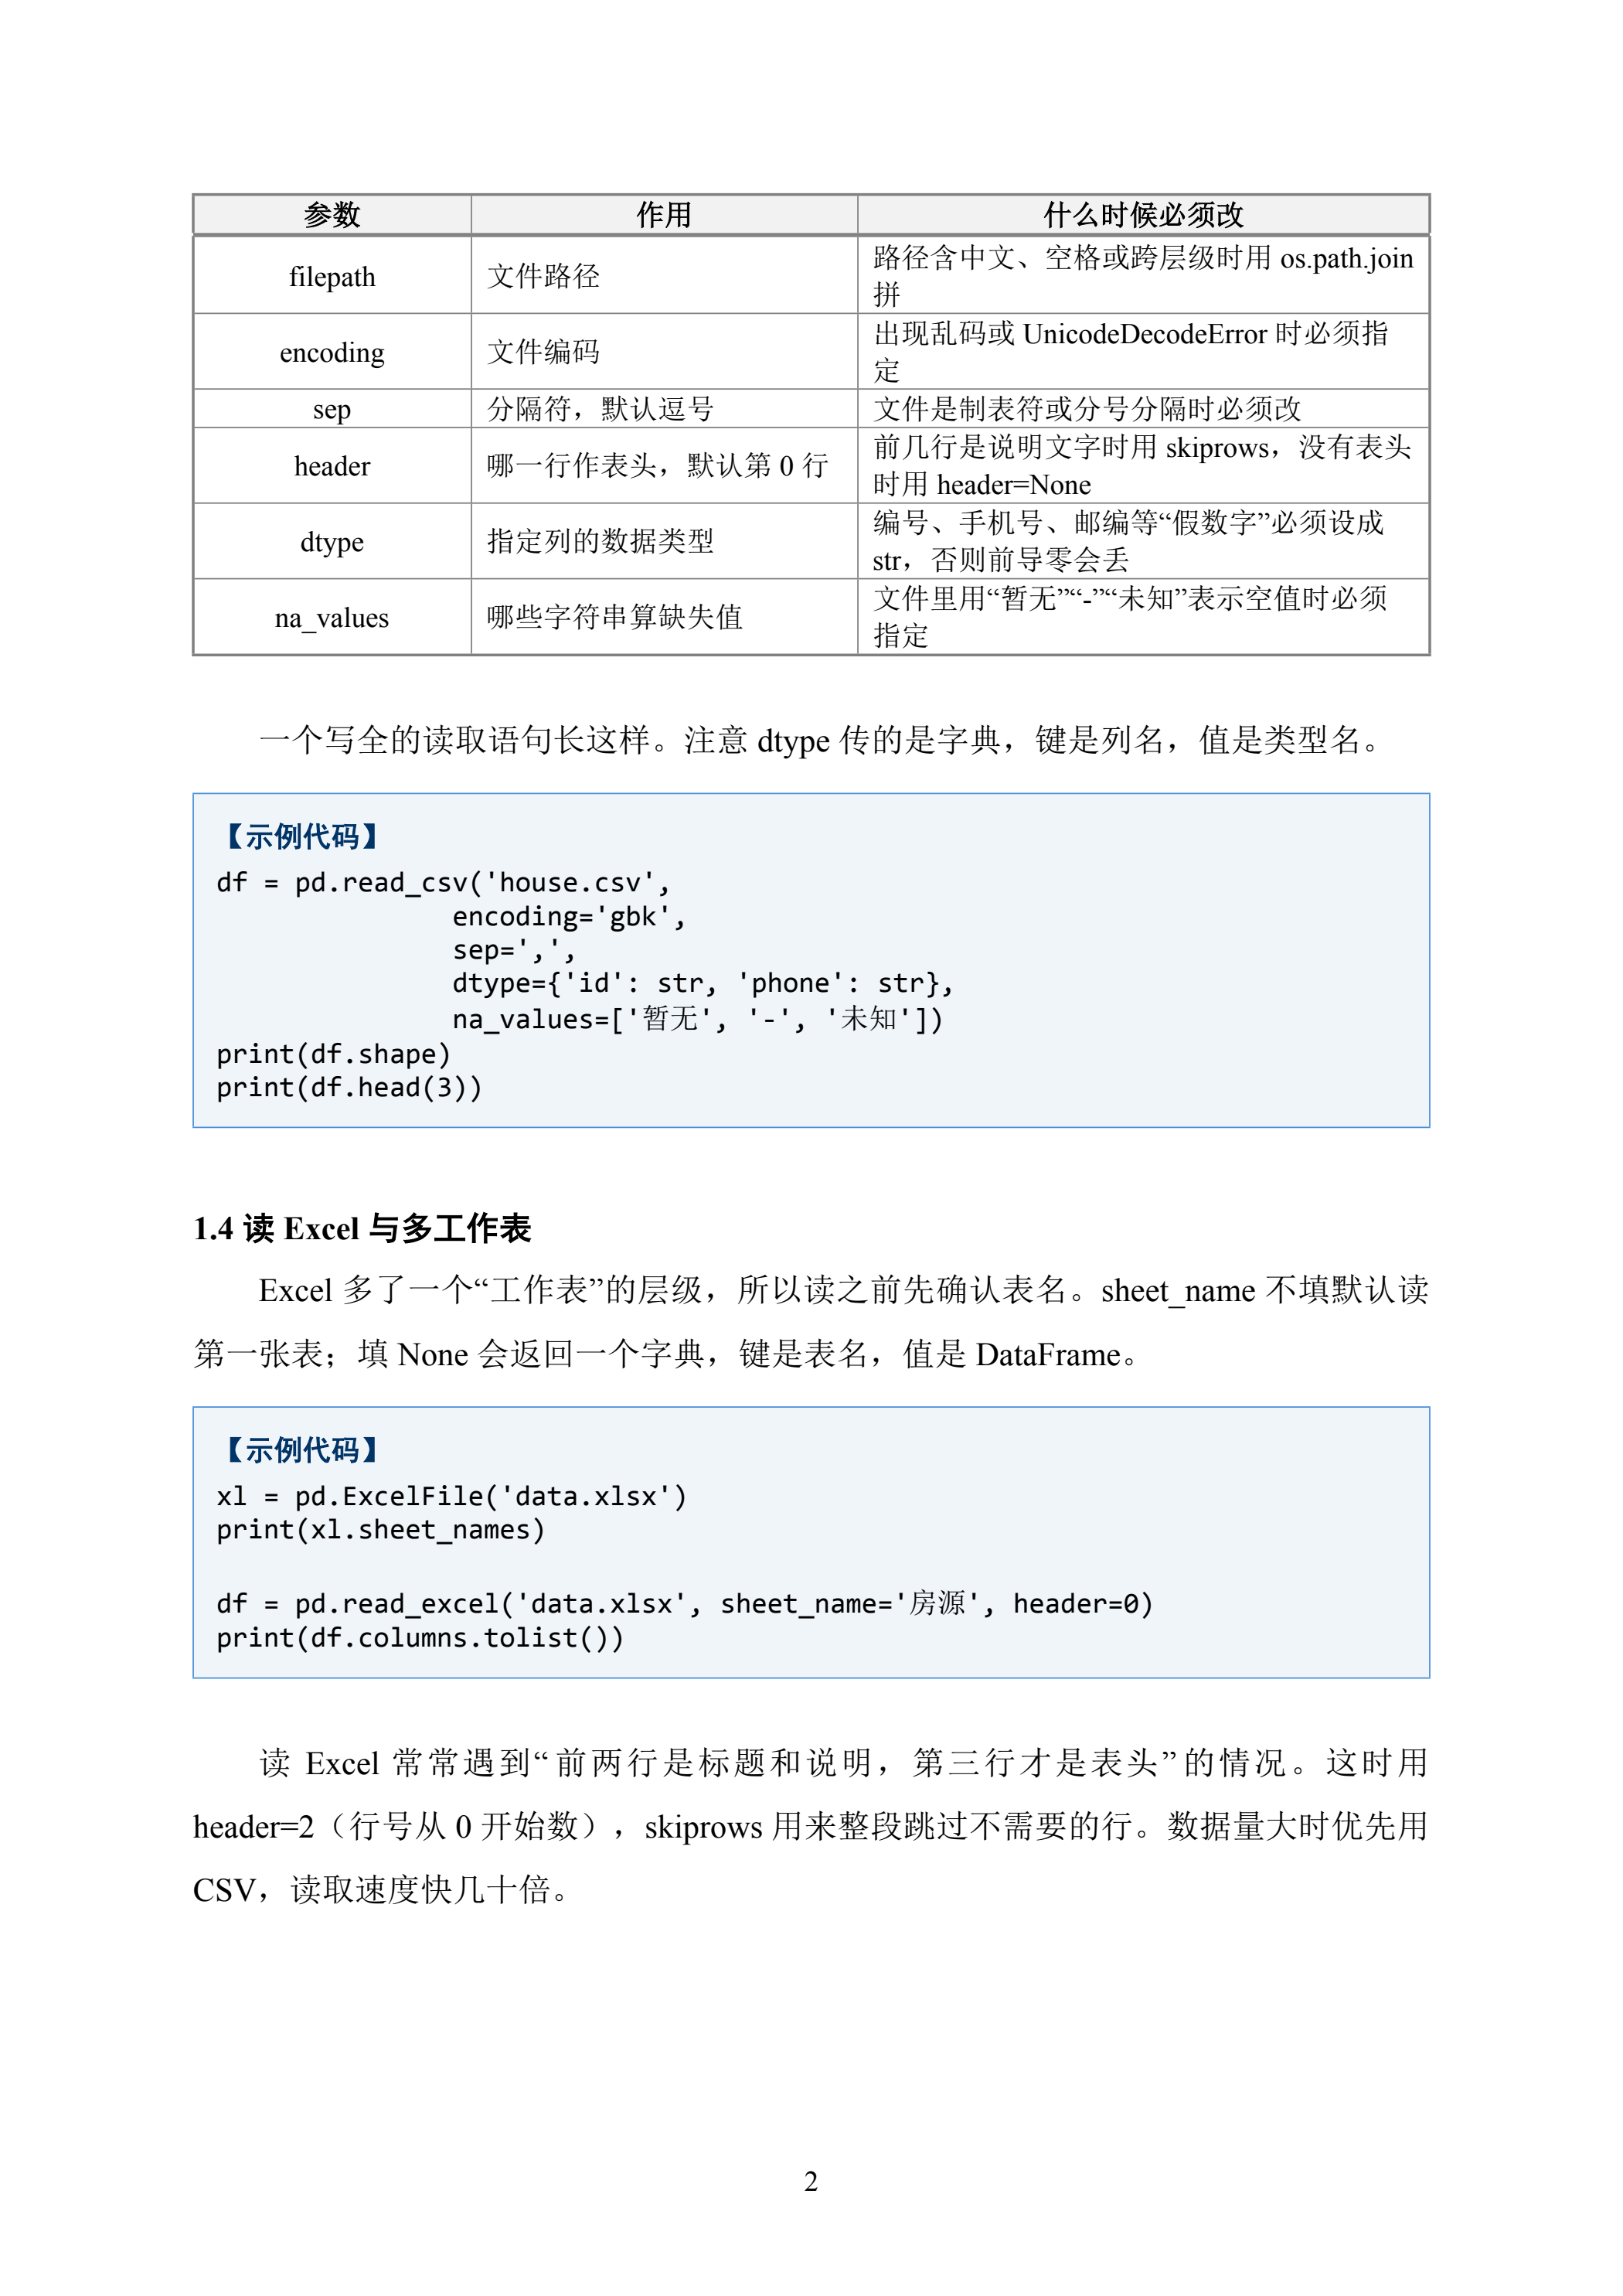
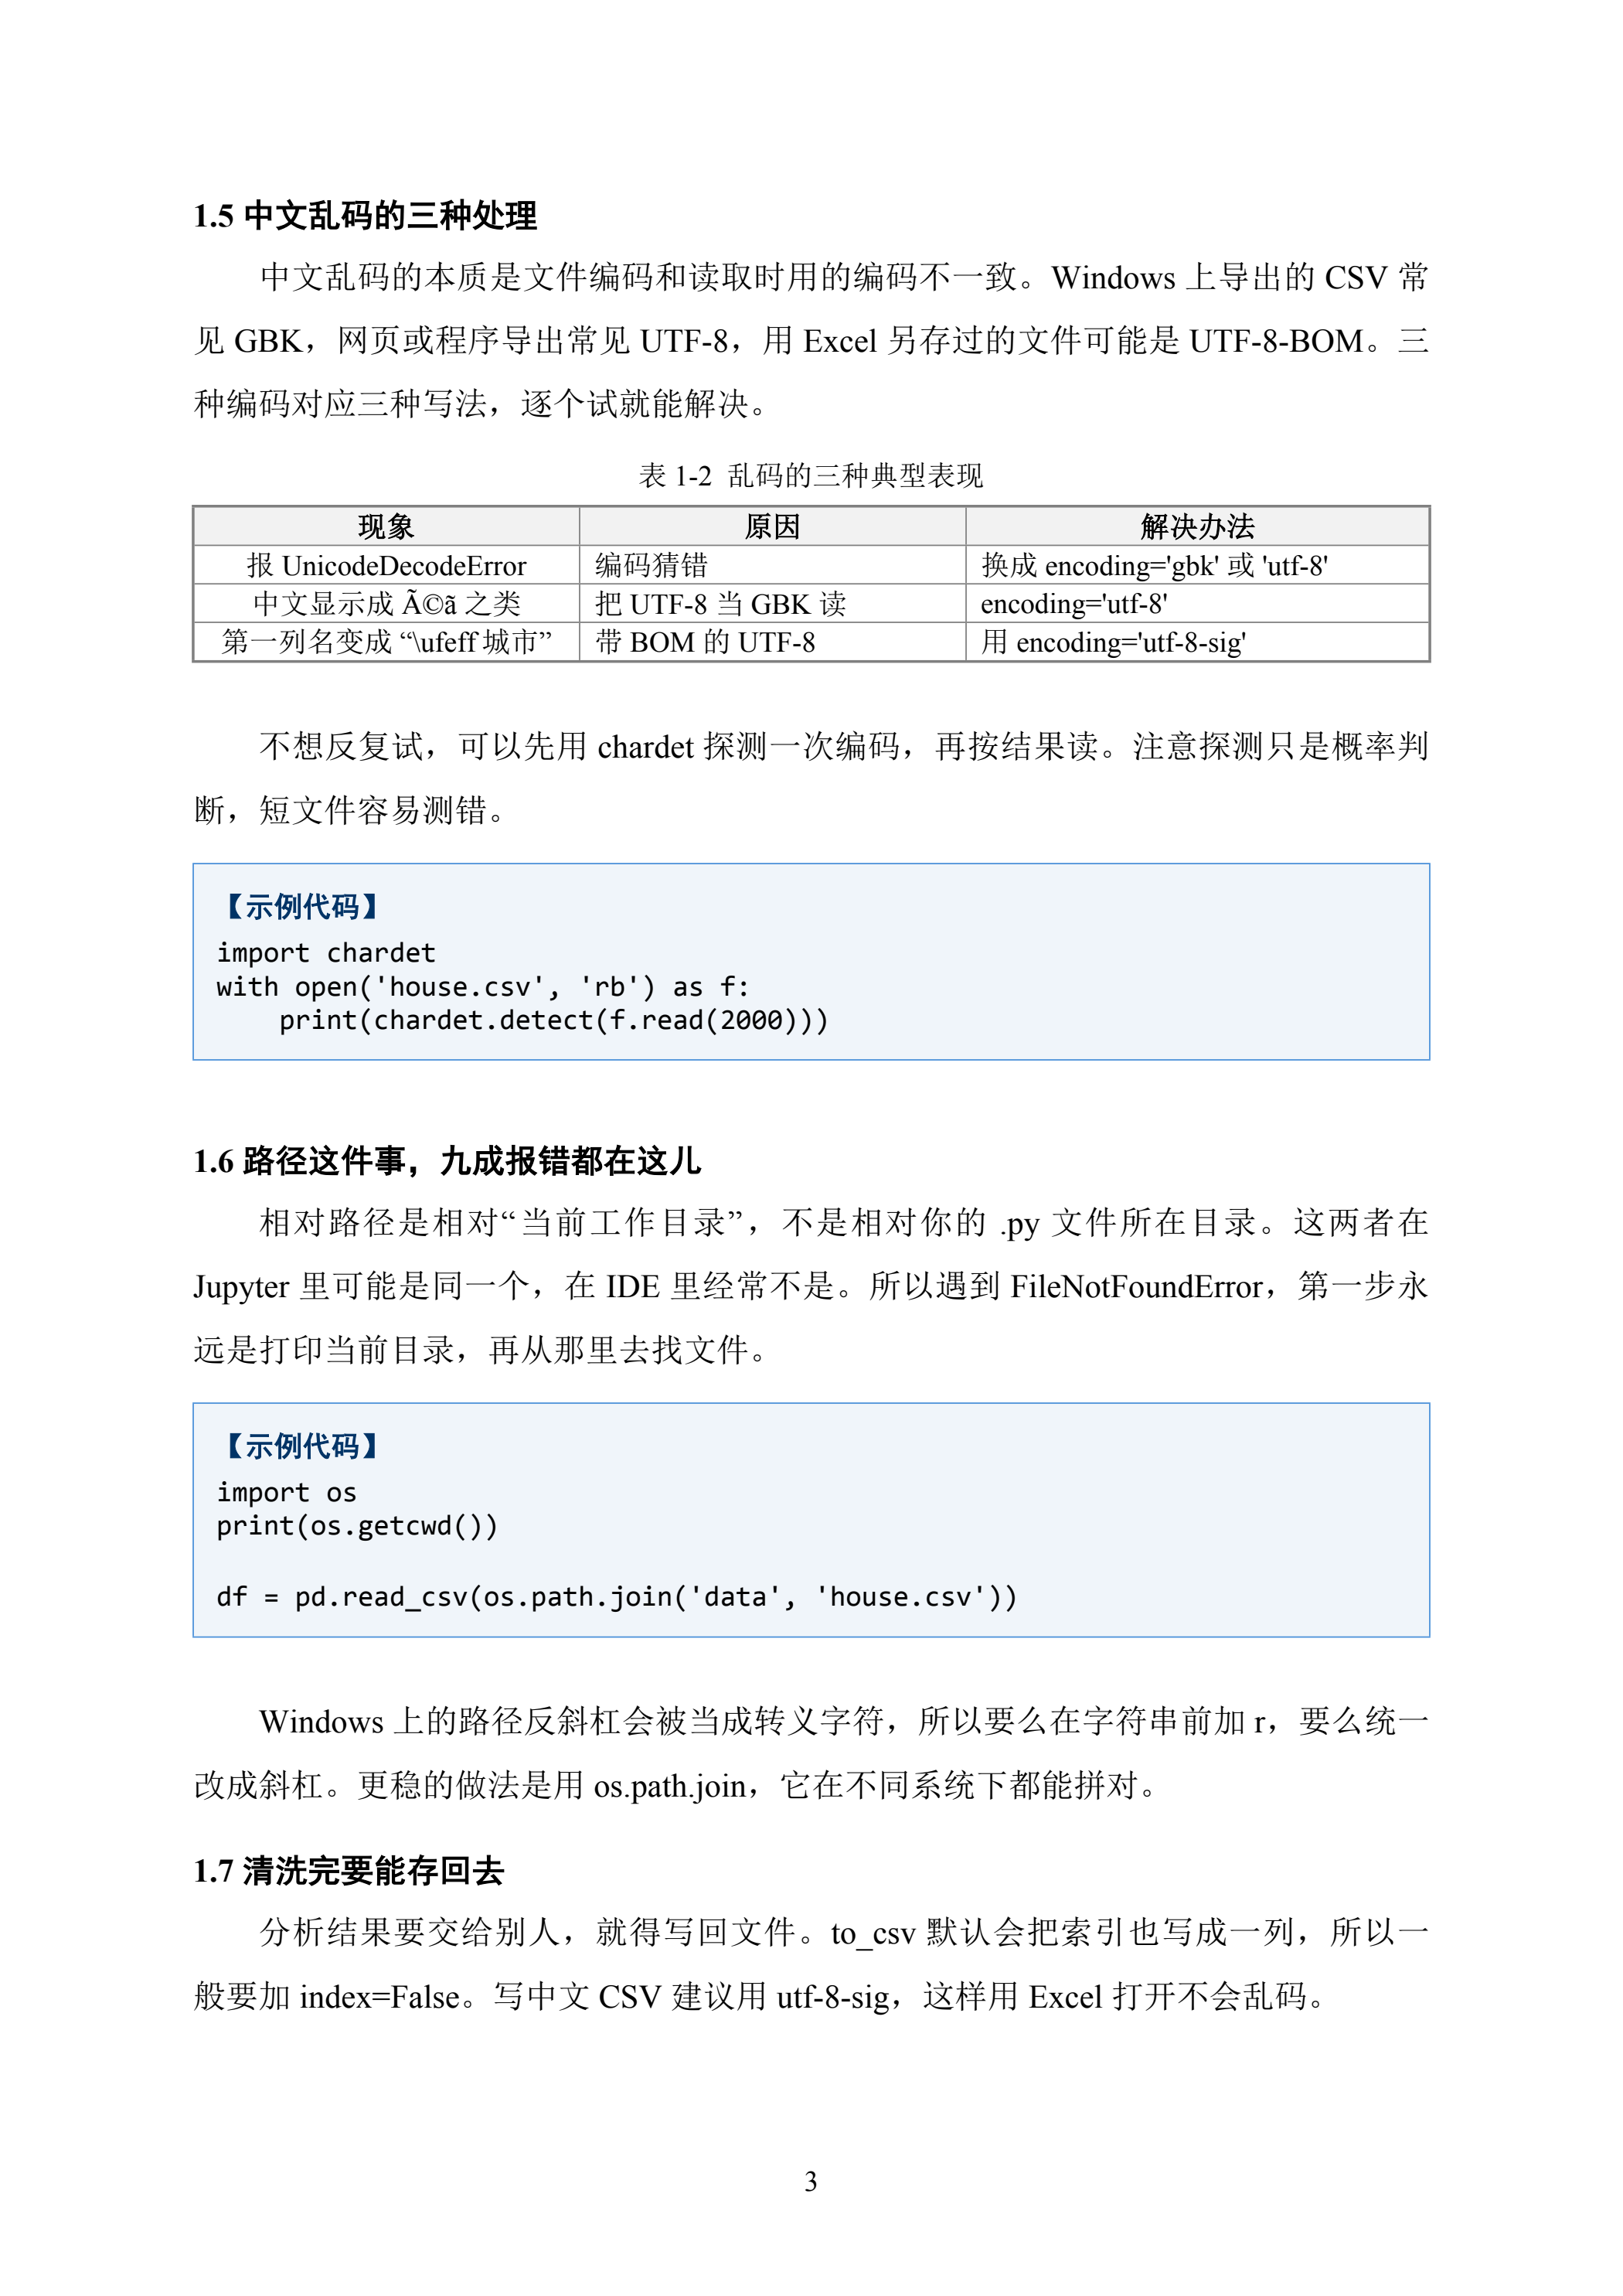
# `' _2 Z8 S; \1.3 读取外部文件3 Q B2 h) P" ^/ `+ I1 z- t5 J+ e
$ V) w; _8 k' v! u0 {: Epython6 @) `$ n. }8 ^6 W# C
8 P4 I: Z* o' h d/ _& H
# 读取csv5 ]7 B/ f6 m/ [4 s3 o* L
df = pd.read_csv("house.csv") A; v+ T; h; j+ C) O8 Y7 K
# 读取excel,需要安装openpyxl2 e$ z+ @) R4 p$ |4 n# u
df = pd.read_excel("house.xlsx")
/ ?$ x" \/ r) ]5 n/ b# 查看前5行
Y) Y+ Z$ W# j- r3 T( e& W* Z: `print(df.head())
: }8 n2 K7 M0 {! r% i" H- J+ ^: u j, b' d# 查看基础信息$ V/ ^# Z6 V2 x: p2 T: B9 z
print(df.info())3 J! y6 b9 J \7 ]
# 查看统计描述$ m9 x7 g0 K: L' ^4 ]/ `9 u
print(df.describe())8 Y2 e j+ ?$ @
* v: y' o, e0 @! e
- k% A+ u9 V1 z+ L, T0 I7 o( R
1.4 基础查看命令
m" X, f- n. ?9 Y
5 s7 C+ q' u! Vpython1 Z- H5 g9 @% B" C: ~) H3 n
$ \9 H" v. `3 s3 s0 @( i! N6 R7 G) h5 Adf.shape # 行数、列数9 L! p: O2 D" [ r- P4 v! W
df.columns # 全部列名, b# G) U" Q) {" b
df.dtypes # 每一列数据类型2 t* g5 i9 r* _/ h' u
/ o4 H1 ^5 a. k & M+ t8 T/ K9 E. j0 }& _; \8 P
, c4 J3 d, a8 c( X, V
) w' s& I1 F6 v第2章 数据清洗
* _8 S1 u; j7 }$ e1 D+ d4 G8 L& y, r
# F, p4 T1 e% w! T( v" k) ~数据清洗是数据分析最耗时的环节,目标:处理缺失值、重复值、异常值( H. f! v' o. S! X) `4 k
3 h2 i7 E. n. p: j& h! o9 W! F' J! cpython! w% p' E6 X$ q0 Y
; X _6 K* h: m+ {3 F& b
# 检查缺失值$ w1 R8 Y. A0 k/ ~
df.isnull().sum()) L2 b4 X- I( u
# 删除存在缺失的行
$ B' ]/ ]3 b' H7 b# @% I& Y* \+ O2 w0 idf = df.dropna(). W9 m1 s4 {6 M7 i: o
# 填充缺失值(均值填充)1 ~$ o/ P( k+ P$ H; X
df["price"] = df["price"].fillna(df["price"].mean())7 k! R3 f! C. C1 T7 n* a; w
& H3 Y1 b: F$ [% h, L
# 删除重复行
- h, o" K; Q6 k2 X3 wdf = df.drop_duplicates()
) `" K! l7 Z, V/ `, g, {! T* }1 f( A3 V. @% \2 k. B Y
# 筛选异常值:房租大于0: |8 F( ]9 c1 a
df = df[df["price"] > 0]
7 N. |- n8 X7 E1 v/ m. P f+ P. o2 h 8 Y# W- h/ n6 u4 y: G
0 p- F. l( p, o% R笔记说明:租房数据里经常会有空租金、重复爬虫数据,这几段是项目里高频代码。
& Z0 V; ~% h# { n - \0 n( H* C& c' _( k% ~& y+ z
+ a) ~+ z& E2 `, S) F+ J4 o 4 e: S" Q' a! j5 Q
第3章 数据筛选、分组与聚合
# M( x6 [5 v4 M
) H3 h% A5 o# G! r3.1 条件筛选
$ D2 N9 W* K( V T2 G
7 i+ g8 e6 o- ~8 o" m( gpython
! h) N2 F) @- H" ]% q3 u+ m 9 d" b7 B% ?# r0 D
# 筛选租金小于2000的房源
H, V8 P. Q6 Z7 \2 J/ {/ Kdf_cheap = df[df["price"] < 2000]& t& O8 G3 q4 W+ P
# 多条件筛选:2000以内 + 朝南) M1 V% Y. c' V5 V5 [# _
df_filter = df[(df["price"]<2000) & (df["direction"]=="朝南")]' ^/ q2 X* q3 p. j4 g
/ H: g6 v2 h) s4 _, Q; u( i
: Y9 q! K; ^- b2 k$ H; u
3.2 groupby分组聚合6 r3 X' n' J R! W" P ^
m. T% Y. f2 R
python
0 P* n$ g/ j7 w, S, o w& ?
) x3 R, H) I; m* f7 L' X; G% g# 按区域分组,求各区平均租金
# K2 u: k) z! z) |- Iarea_avg = df.groupby("area")["price"].mean().reset_index()
1 K$ {. Z3 c: U. i ~# 统计每个区域房源数量$ T. y. `; T& ?
area_count = df.groupby("area").size().reset_index(name="count")- v/ G: c9 F- \. b" K- l
4 }0 y; p# C& q% ^& i' m' {
2 ] S- |+ `# O5 d
& T) O8 N/ r7 }1 W5 a4 x" j W 3 b- T* V! J1 \
第4章 字符串、时间格式处理4 Z0 A$ W8 T1 a# o( \; Z
" @7 @$ s0 Q( p8 `" x
4.1 字符串处理(拆分户型、面积); n& W: [& f3 J3 f( z
; }/ I9 u' E& z- X9 C0 q3 d% Zpython
0 @0 D' _; Y: z# O+ Q& _& s
/ S+ h/ {/ K2 y# 提取面积数字,例如"65㎡"提取65
: F D4 t8 o; w+ O% ?- Mdf["area_num"] = df["size"].str.extract("(\d+)").astype(float)
1 q# x; R- X/ l4 e% M1 X+ Y. h
0 p: f1 s; K8 v( W+ Y
. v( \4 z0 x, I \2 L4.2 时间转换# h- \6 o- k+ F; c" J) e$ a3 z; t$ I
9 o3 U9 O0 i$ l& _0 k+ cpython& C1 a4 c* `1 A
6 A/ N" }1 m3 b, r) {# 字符串转时间格式
. l, T1 P q+ L! N' ]df["publish_time"] = pd.to_datetime(df["publish_time"])
4 R) O' u1 z( f) ~( U: s( g% C+ L. ]# 提取月份
2 o; b* ~' l5 x/ ydf["month"] = df["publish_time"].dt.month5 t/ A9 j7 t/ I* b2 E. Z" g- Q
4 ]$ \, n g% ], Y8 B- ` 5 a3 `# i& u) n1 o6 [
# e* s5 G N6 I7 c: z8 E 5 e; f& B8 C T! [6 p
第5章 Matplotlib基础可视化0 k* x6 y4 [' S7 }+ q7 O
$ ~6 ?, M, u% V0 p1 j |& o+ Y$ o& p
python9 m# a! s' I8 q3 L% k
, f% A& f! C0 [! p
# 绘制各区平均租金柱状图
; N0 l* `* K: ?4 Gplt.figure(figsize=(10,5))* l* ?( u, v2 O: W# c' r. w
plt.bar(area_avg["area"], area_avg["price"])
( u% w0 P" c9 h+ lplt.title("各区域租房平均租金")
; m; i7 y# r! ?5 ]6 [6 @$ nplt.xlabel("区域")8 }* o/ w2 Q7 t* F( T5 |2 ~0 N! P3 V
plt.ylabel("平均租金(元)")
, B% C7 I% F6 v; I6 yplt.xticks(rotation=45)6 g9 O% I u: g( s( p
plt.tight_layout()4 m6 U% M5 H; E. f" i
plt.show(), `# ]+ H# \9 @6 w h
7 V: D2 j! Q3 @. e# G- N- @
; k& F/ f1 j1 _! s) C
' B; |: Q5 w3 C' p. u / g; ~0 l- D3 N0 U
第6章 实战:租房信息采集与可视化(毕设项目)/ H# ?, m% H* h2 ]0 z
3 n/ R1 _$ |0 p9 N+ m$ I& F项目背景:本项目为大数据专业课程设计/毕业设计简易版本,实现租房数据读取、清洗、统计、可视化,可扩展Flask网页展示。' m+ v' d* c8 o" X" ~* N
! N& \+ z3 D: H* V( T$ H) k# y) K1 wpython
- x5 E" m1 P2 F; Q- y' g
) H6 N8 T- }. Q3 yimport pandas as pd
" Y& M" I$ y* }% eimport matplotlib.pyplot as plt
+ f/ r. ^+ ?" A1 }, T) W4 _; _7 {1 T& V# f
plt.rcParams["font.sans-serif"] = ["SimHei"]1 e* o9 F, t0 R# q5 {
plt.rcParams["axes.unicode_minus"] = False
3 h g* l+ ~" W/ {; r2 z7 Y, P: F9 n0 y6 M
# 1.读取数据( M8 L( k9 ]* _$ k8 M3 R- c) |
df = pd.read_csv("house.csv")
+ |6 \& g; j0 }: J5 L5 N* F* z# 2.清洗 Y9 y5 I* H# a: D" ]) E! U* ]
df = df.dropna()
3 B) Q5 u2 B' n4 n% l) {( n$ e0 Qdf = df.drop_duplicates() X: y% R1 t% T( x0 @3 D9 F& G8 m
df = df[df["price"]>0]
t4 ?( u) N' @0 h! e# 3.分组统计- l4 r2 s: U8 i1 o: X
res = df.groupby("district")["price"].agg(["mean","count"]).reset_index()
. q; a5 t: r/ W, ?1 }res.columns = ["区域","平均租金","房源数量"]
& q, H. Q' }$ D0 Y# 4.绘图0 ~. A# W8 z# a) ?8 h
plt.figure(figsize=(12,6))9 L! U" j: P! n9 O! F7 D- p
plt.bar(res["区域"], res["平均租金"], color="#4472C4")+ O5 ~$ o3 b, Z
plt.title("武汉各区域租房均价统计")
' J* y8 ?2 ~$ o% R: l7 wplt.ylabel("均价")3 n% w$ V3 ?+ L) W6 Z
plt.xticks(rotation=45)2 T, d5 I; b1 ?* w
plt.tight_layout()- E$ I9 g+ X: | J4 M1 v' W: j, i
plt.show()# z `6 w9 r9 b) e8 h! i T
# 5.输出结果5 B' h, Y8 U i
print(res)
" `; _* Q- B# x; h/ _ / s& ]: M3 y+ g* C+ I9 m6 V+ l4 b/ O3 j4 C
) M/ D: b+ x8 }. W4 V拓展方向:
* b" u7 C) K! ^) y- b5 O
# R! ~9 f9 u$ b1. 接入爬虫获取实时房源6 ?. L, a. W M$ \6 n2 ~* n6 E
2. 使用Flask搭建网页可视化页面1 K: x0 O: _1 A0 g# E# z' o
3. 增加租金分布直方图、箱线图
6 O5 `4 _* T5 P' L- v4 R
0 e6 m: P9 k/ a {1 d4 Q! J 1 ^" z' `7 d( i* v4 P* _" R( l4 R# a
7 l$ i7 Q9 f1 F( Q! c
附录A 常见报错速查. M1 I9 G1 o# p1 n0 ^
( M- o; z! E8 c, ?3 q1 M
1. ModuleNotFoundError: No module named 'pandas' → 没有安装包,执行pip install+ d9 ^; c* j1 R" _9 a" j9 N/ y
2. 中文方框乱码 → 缺少字体设置代码,复制字体那两行, o, F) l( G, a$ p! y1 T! _
3. ValueError: cannot convert float NaN to integer → 数据存在空值,先dropna或者fillna
) I- ~& j, ?; S2 f6 [4. 索引对齐报错 → 检查分组、筛选的时候有没有空数据2 U3 I2 c- k) a2 Q5 i
$ u. K: \! `; @: C附录B Pandas高频函数速查表
1 k. `! I. o0 {* [6 q6 ?$ X6 b
& m( I3 q E' Q3 o, R: I( \) Z. O% i功能 代码
9 J0 F0 ~7 x d8 \; S/ y读取csv pd.read_csv()
" ?8 B1 Y ?1 I9 F- M2 X! I空值检查 isnull().sum() 5 g6 t+ Q6 l8 t! W- ]
删除重复 drop_duplicates() 2 e! R7 f) d3 S( i" z1 W( [# B
分组 groupby() ; _2 r* B& ^+ P4 u6 c
排序 sort_values() & p0 `* N2 V2 U" l8 @! [% }0 W
保存结果 to_csv() 3 T8 v! I$ G( t! [- T
3 Z$ m! s3 n/ i5 H附录C 配套练习题+参考答案
: p* q; y6 `# h ]/ M9 g% |# P & d0 v5 f7 W& Q/ }" J! @2 Z5 R
1. 题目:筛选租金1500-3000之间的房源
1 S+ S! @, S! s1 D- ?7 P参考答案:
8 o) M7 @9 X' h& _8 f0 k* y$ l
+ D4 g* l6 [! n1 b# b* b" i+ Spython
p& @8 r, U7 i- \. g
$ ^8 S2 `* w* R* g$ ?6 qdf_new = df[(df["price"]>=1500)&(df["price"]<=3000)]
3 c/ Y1 N- u/ z $ f* k# V1 _$ s% w$ c4 b7 E! `" H
7 |* u6 l+ F8 b2. 题目:按户型分组,统计房源数量$ Y, c$ A7 L( U9 u# U5 }: u( D5 U0 Z
参考答案:/ X- P1 w) \0 q) y
+ L5 l1 L- V- t" B$ k. i ^# [7 tpython$ U* t" i: l5 C5 B3 y. w
2 e; { g7 J2 _ \df.groupby("house_type").size
7 K- Z* i. y9 C7 Z3 l8 H" _2 Q
' K* `/ w0 Z; l; |' m' {: R7 q# C; g D" Y/ l% r& I
2 ^" ~* f3 W/ m8 B1 U. O
Python数据分析速成笔记(Pandas数据清洗+Matplotlib可视化+实战案例)4 A9 C# g+ z& V0 D0 x. t- K
" V( |! I- t1 a$ R# n, U" ~
5 ?0 r8 l0 F# |/ r# T; ?7 {内容概述:本资料为本人学习整理的原创笔记,共 6 章 + 附录,约 30 页。覆盖 Python 数据分析全流程:数据读取(CSV/Excel/中文编码处理)→ 数据初探与清洗(缺失值、重复值、类型转换、异常值处理)→ 数据筛选与分组聚合(loc/iloc、groupby、agg 常用组合)→ 时间与字符串处理 → Matplotlib 可视化模板(柱状图、折线图、箱线图、散点图、热力图,含中文字体配置与图表规范)→ 一个完整实战案例(租房信息数据清洗与可视化分析,从原始 CSV 到结论输出)。附录整理 10 个高频报错及修复方法(中文乱码、SettingWithCopyWarning、KeyError、类型转换失败等)和四张常用操作速查表。所有代码均经本人环境实测可运行,关键步骤附注释与每一步的 shape 检查说明。! v+ |$ O& ]7 |# V- y
: J1 d. o; H- L1 P; R适用人群:1)正在学期数据分析、Python 数据处理课程的同学,可当期末复习提纲;2)准备数据分析/大数据岗位实习面试,需要快速补齐 Pandas 实操的应届生;3)零基础转行、不想死磕语法、只需要看懂代码并改参数的学习者。9 c5 f' |8 _$ A4 O5 W1 x
5 Q0 [8 g5 |0 f( e7 N7 y
使用方法:建议按章节顺序边看边敲,每章末尾的代码块可直接复制到 Jupyter Notebook 运行;第 6 章实战案例可替换成自己的 CSV 数据练手。若只想应急,优先看第 2、3 章(清洗与聚合)和附录报错速查,能覆盖 80% 的日常需求。
. h! Z0 e6 w) N4 `, T
4 a1 f( U4 O( N1 k附:附件首页即目录,可按目录快速定位;重要表格与代码均已排版为可直接照敲的格式。
! Q5 o8 T, A2 L |7 z: x1 N |
 学研领航向全体高校师生打造的一站式综合交流与资源服务平台,集知识学习、经验分享、资源下载、互动问答、职场成长、兼职实践于一体,覆盖校园生活、专业学习、求职就业、兴趣发展等全场景需求。